El mensaje que yo no enviaría todavía
Imagina que estás viendo un vídeo sobre cómo hacer pan. Junto al reproductor aparece una miniatura titulada «Cómo preparar masa madre». Si pulsas esa miniatura, se abre el vídeo recomendado. La plataforma también puede mostrar esa misma recomendación más abajo, en la lista de sugerencias. Cuando hablemos de la posición, nos referiremos al lugar de la pantalla donde apareció la miniatura.
Cada vez que una miniatura aparece en pantalla, la plataforma registra una impresión. Si pulsas dos veces la misma miniatura durante esa impresión, sigue siendo una sola impresión con clic. Si la miniatura nunca llegó a mostrarse, no entra en la cuenta.
Ahora imagina que entre el lunes y el martes cambiamos el sistema que elige qué vídeos recomendar. El lunes, de cada cien impresiones, 26 recibieron al menos un clic; el martes fueron 64. Yo enviaría esas cifras a dirección. Lo que aún no escribiría es «hemos acertado con el cambio». ¿Y si el martes muchas más recomendaciones aparecieron junto al reproductor, justo donde la gente suele pulsar más?
Lo primero que se pierde al guardar un dato
Para ver qué podemos averiguar, anotemos cuatro ocasiones en las que apareció una recomendación. Cada fila de esta tabla corresponde a una de esas ocasiones. El número de la izquierda sirve para señalarla; un mismo vídeo podría aparecer más de una vez.
Cuatro impresiones de prueba| Impresión | ¿Dónde apareció la miniatura? | ¿Alguien la pulsó? |
|---|
| 1 | Arriba | Sí |
|---|
| 2 | Arriba | No |
|---|
| 3 | Abajo | No |
|---|
| 4 | Abajo | No |
|---|
Si elijo al azar una de las cuatro impresiones, ¿cuáles podrían tocarme? Cualquiera de las cuatro: ese conjunto es el espacio muestral, \(\Omega\). Si pregunto en cuáles apareció arriba la miniatura, puedo señalar la 1 y la 2. Llamaré \(A\) a ese conjunto. Si pregunto en cuáles hubo clic, solo puedo señalar la 1. Ese es el conjunto \(C\):
\[\Omega=\{1,2,3,4\},\quad A=\{1,2\},\quad C=\{1\}.\]
Tapa con la mano la columna del medio. Todavía puedes contar cuántas recomendaciones recibieron un clic. Pero mira los tres «No»: ¿cuál de ellos corresponde a una miniatura que apareció arriba? Lo sabías con la tabla completa. La respuesta «No», por sí sola, no te lo dice.
Eso mismo ocurre si la plataforma solo guarda un bit por impresión: una casilla con dos valores posibles, 1 para «hubo clic» y 0 para «no hubo clic». El 1 distingue la primera impresión; el 0 agrupa las otras tres. Con ese único dato puedes seleccionar el primer grupo, el segundo, ambos o ninguno. En probabilidad, esa familia de cuatro conjuntos se llama \(\sigma\)-álgebra generada por el bit:
\[\sigma(C)=\{\varnothing,C,C^{\mathrm c},\Omega\}.\]
Cada rectángulo representa \(\Omega\): las cuatro impresiones. El círculo contiene la única con clic, \(C=\{1\}\). El violeta indica la región seleccionada.\(\varnothing\)Ninguna
\(C\)Con clic
\(C^{\mathrm c}\)Sin clic
\(\Omega\)Todas
La letra griega \(\sigma\) se lee «sigma». Aquí, \(\sigma(C)\) nombra la colección de sucesos que puedes distinguir si lo único que sabes de cada impresión es si hubo clic. Las llaves enumeran esos sucesos. Vamos a leerlos en el orden en que aparecen:
- \(\varnothing\) es el conjunto vacío: no seleccionas ninguna fila.
- \(C\) es «hubo clic»: seleccionas solo la fila \(1\).
- \(C^{c}\) se lee «complemento de \(C\)». La \(c\) pequeña indica que tomas todas las filas que quedaron fuera de \(C\): las impresiones sin clic, es decir, las filas \(2, 3\) y \(4\).
- \(\Omega\) es el conjunto completo: seleccionas las cuatro filas, tanto si hubo clic como si no.
¿Qué miniaturas aparecieron arriba? Con la tabla completa basta con filtrar por «posición = arriba». El resultado son las impresiones \(1\) y \(2\). A ese resultado lo llamamos \(A=\{1,2\}\).
Ahora borra la columna «posición». Solo puedes filtrar por clic. Prueba los dos valores:
\[\begin{aligned}
\text{Con clic} &\longrightarrow \{1\} \\
\text{Sin clic} &\longrightarrow \{2,3,4\}
\end{aligned}\]
Necesitas la fila \(2\) porque su miniatura apareció arriba. Pero si pides «sin clic», el filtro también devuelve las filas \(3\) y \(4\), cuyas miniaturas aparecieron abajo. Las tres tienen un \(0\) en la única columna que conservaste. ¿Y si juntas los dos resultados? Obtienes las cuatro filas. Tampoco así consigues solo la \(1\) y la \(2\).
\[A \notin \sigma(C)\]
El símbolo \(\notin\) se lee «no pertenece a». Aquí dice algo concreto: el grupo «apareció arriba», \(A\), no está entre los cuatro grupos que puedes seleccionar con el dato de clic. Si quieres saber qué posición recibió más clics, guarda la posición junto al clic cada vez que se muestre una miniatura.
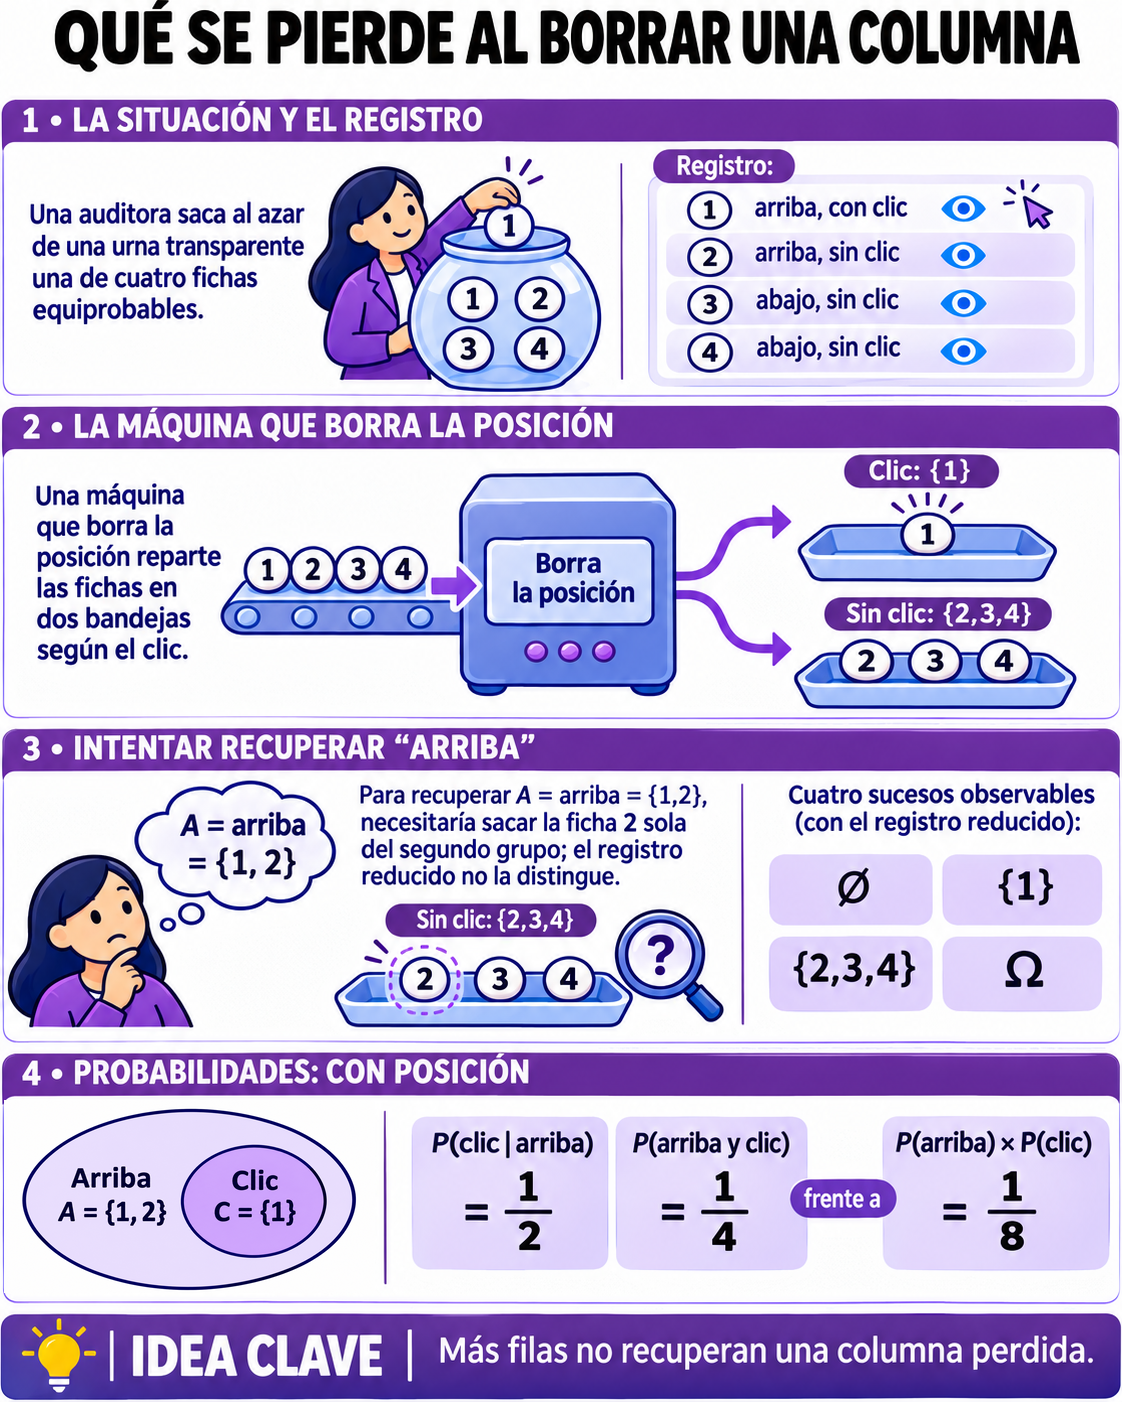 Figura 1. Con solo el clic se distinguen cuatro sucesos. Con posición también se puede verificar que \(P(C\mid A)=\tfrac{1}{2}\) y que \(A\) y \(C\) no son independientes.
Qué probabilidad tiene cada fila
Escribe los números de las cuatro impresiones en cuatro fichas iguales, mézclalas y saca una sin mirar. Cada ficha tiene la misma probabilidad de salir: \(\tfrac14\). Llamamos \(P\) a la regla que asigna probabilidades. Para que esa regla sea válida, tiene que cumplir los tres axiomas de Kolmogórov:
1. Ningún suceso tiene probabilidad negativa. Si \(E\) es un suceso, como «sacar la ficha con clic», su probabilidad cumple:
\[P(E)\geq 0.\]
En la tabla solo hubo clic en la primera impresión. Por eso \(P(C)=\tfrac14\). Un suceso imposible, como sacar la ficha número cinco, tiene probabilidad cero.
2. Algún resultado del sorteo tiene que ocurrir. El conjunto de todos los resultados posibles es \(\Omega\):
\[P(\Omega)=1.\]
No sabes qué ficha vas a sacar, pero sí sabes que será una de las cuatro. En este sorteo puedes comprobarlo sumando sus probabilidades: \(\tfrac14+\tfrac14+\tfrac14+\tfrac14=1\).
3. Puedes sumar las probabilidades si los grupos no comparten fichas. Por ejemplo, «sale la ficha 1» y «sale la ficha 2» no pueden ocurrir a la vez. La probabilidad de sacar cualquiera de las dos es \(\tfrac14+\tfrac14=\tfrac12\).
La misma regla vale para una lista numerable de sucesos \(E_1,E_2,\ldots\), siempre que ningún par comparta resultados:
\[P\!\left(\bigcup_{i=1}^{\infty} E_i\right)=\sum_{i=1}^{\infty}P(E_i).\]
El signo \(\bigcup\) reúne los grupos: a la izquierda se pregunta por la probabilidad de que la ficha salga de alguno de ellos. El signo \(\sum\) suma sus probabilidades. Si una ficha estuviera en dos grupos, esa suma la contaría dos veces.
Que cada ficha valga \(\tfrac14\) depende de haber elegido un sorteo uniforme. Los tres axiomas también se aplican a sorteos en los que unas fichas salen con más frecuencia que otras. 1
Con las mismas cuatro fichas podemos ver qué cambia al preguntar «o», «y» o «sabiendo que». El rectángulo de cada dibujo contiene todas las impresiones. El óvalo grande rodea las que aparecieron arriba, \(A=\{1,2\}\). El círculo pequeño rodea la que recibió clic, \(C=\{1\}\). Dibujamos el círculo dentro del óvalo porque, en esta tabla, el único clic ocurrió arriba. Si preguntas por una impresión sin clic, mira fuera del círculo pequeño: quedan las fichas \(2,3,4\). Ese es el complemento de \(C\), y su probabilidad es \(3/4\).
Unión: ¿qué fichas cumplen al menos una condición? Pide las que aparecieron arriba o recibieron clic. La ficha 2 entra porque apareció arriba, aunque nadie pulsó. La ficha 1 cumple ambas condiciones y también entra, pero sigue siendo una sola ficha. El signo \(\cup\) significa «unión»:
\(A\cup C=\{1,2\}\). El violeta cubre todo el óvalo, incluido el círculo interior.El dibujo indica qué fichas entran en la unión. Para calcular su probabilidad, suma la de aparecer arriba y la de recibir clic. Después resta la probabilidad de que ocurran ambas cosas: las fichas que cumplen las dos condiciones ya han entrado dos veces en la suma.
\[P(A\cup C)=P(A)+P(C)-P(A\cap C)=\tfrac24+\tfrac14-\tfrac14=\tfrac12.\]
El término que restamos corresponde a la ficha \(1\): apareció arriba y recibió clic. Puedes comprobar el resultado contando las fichas violetas. Hay dos de cuatro y todas tienen la misma probabilidad de salir.
Intersección: ¿qué fichas cumplen las dos condiciones a la vez? Ahora pide las que aparecieron arriba y recibieron clic. La ficha 2 ya no sirve. Solo queda la 1, que está dentro de los dos contornos. El signo \(\cap\) significa «intersección».
\(A\cap C=\{1\}\). Solo la ficha 1 cumple las dos condiciones. Si sorteas entre las cuatro, la probabilidad es \(1/4\).Para calcular la intersección, empieza por las dos fichas de arriba. La probabilidad de sacar una de ellas es \(2/4\). Dentro de ese grupo, una de las dos recibió clic. Por tanto, la mitad de esas dos fichas cumple también la segunda condición. La regla del producto expresa esos dos pasos:
\[P(A\cap C)=P(A)\,P(C\mid A)=\tfrac24\times\tfrac12=\tfrac14.\]
La barra de \(P(C\mid A)\) indica dónde contar: entre las fichas de arriba. Si multiplicaras por \(P(C)=1/4\), estarías usando la proporción de clics entre todas las fichas. Solo puedes sustituir \(P(C\mid A)\) por \(P(C)\) si los sucesos son independientes. Aquí las proporciones son distintas.
Condicionamiento: si ya sabes que la miniatura apareció arriba, ¿qué probabilidad hay de que recibiera clic? Alguien saca una ficha sin enseñártela y te dice: «Es de arriba». Con esa pista puedes descartar la 3 y la 4. La 1 y la 2 siguen siendo igual de probables, y solo la 1 recibió clic.
\(P(C\mid A)=1/2\). Las fichas tachadas quedan fuera del sorteo al saber que ocurrió \(A\). De las dos que quedan, una tuvo clic.La barra vertical se lee «sabiendo que». Empieza por su derecha: \(A\) indica qué filas conservar. Después mira a la izquierda: \(C\) indica qué contar dentro de esas filas. La fórmula divide la probabilidad de cumplir ambas condiciones entre la probabilidad del grupo que conservas:
\[P(C\mid A)=\frac{P(A\cap C)}{P(A)}=\frac{1/4}{2/4}=\frac12.\]
En la intersección contabas una ficha entre cuatro; con la pista cuentas esa misma ficha entre dos. Antes de conocer la posición, la probabilidad de clic era \(1/4\); al saber que apareció arriba, pasa a \(1/2\). Por eso clic y posición no son independientes en este registro. Para saber si mover la miniatura habría provocado un clic, necesitaríamos otra comparación.
Por qué sube el total si bajan las dos posiciones
Cada día se mostraron cien recomendaciones. En la tabla, «8 de 10» significa que se mostraron diez miniaturas y que ocho de ellas recibieron al menos un clic.
Impresiones con clic por posición| Posición | Lunes | Martes |
|---|
| Arriba | 8 de 10 (80 %) | 63 de 90 (70 %) |
|---|
| Abajo | 18 de 90 (20 %) | 1 de 10 (10 %) |
|---|
| Total | 26 de 100 (26 %) | 64 de 100 (64 %) |
|---|
Lee primero la fila «Arriba». El martes hubo más clics allí: 63 frente a 8. Pero también hubo muchas más oportunidades de pulsar: 90 frente a 10. Por eso el número de clics subió mientras que la tasa bajó. Ahora mira la fila «Abajo»: la tasa también bajó. ¿De dónde salieron entonces los 38 puntos de subida del total?
¿Cómo pueden ser ciertas las dos cosas? Piensa en las cien impresiones del martes. Para contar los clics de arriba necesitas dos datos: cuántas miniaturas aparecieron allí y qué proporción recibió clic. Haz la misma cuenta abajo y suma. Esta es la regla de la probabilidad total. En la fórmula, \(d\) es el día, \(z\) es la posición y \(C\) significa «hubo clic»:
\[P_d(C)=\sum_{z\in\{\text{arriba},\,\text{abajo}\}}P_d(C\mid z)\,P_d(z).\]
El signo \(\sum\) pide sumar dos aportaciones, una por posición.
1. Arriba. Para el martes, \(P_d(z)\) vale \(0{,}90\) arriba: nueve de cada diez impresiones estuvieron allí. De esas, una proporción \(P_d(C\mid z)=0{,}70\) recibió clic. Arriba aporta, por tanto, 63 impresiones con clic por cada 100 del día:
\[0{,}90\times0{,}70=0{,}63\]
2. Abajo. Una de cada diez impresiones apareció abajo. De esas, el 10 % recibió clic. Abajo aporta una impresión con clic por cada 100 del día:
\[0{,}10\times0{,}10=0{,}01\]
3. Suma las dos aportaciones. Ambas están expresadas sobre las mismas 100 impresiones. Juntas dan el 64 %:
\[0{,}63+0{,}01=0{,}64=64\,\%\]
El martes, incluso después de empeorar, la posición de arriba seguía recibiendo más clics por impresión. Y ese día casi todas las miniaturas aparecieron allí.
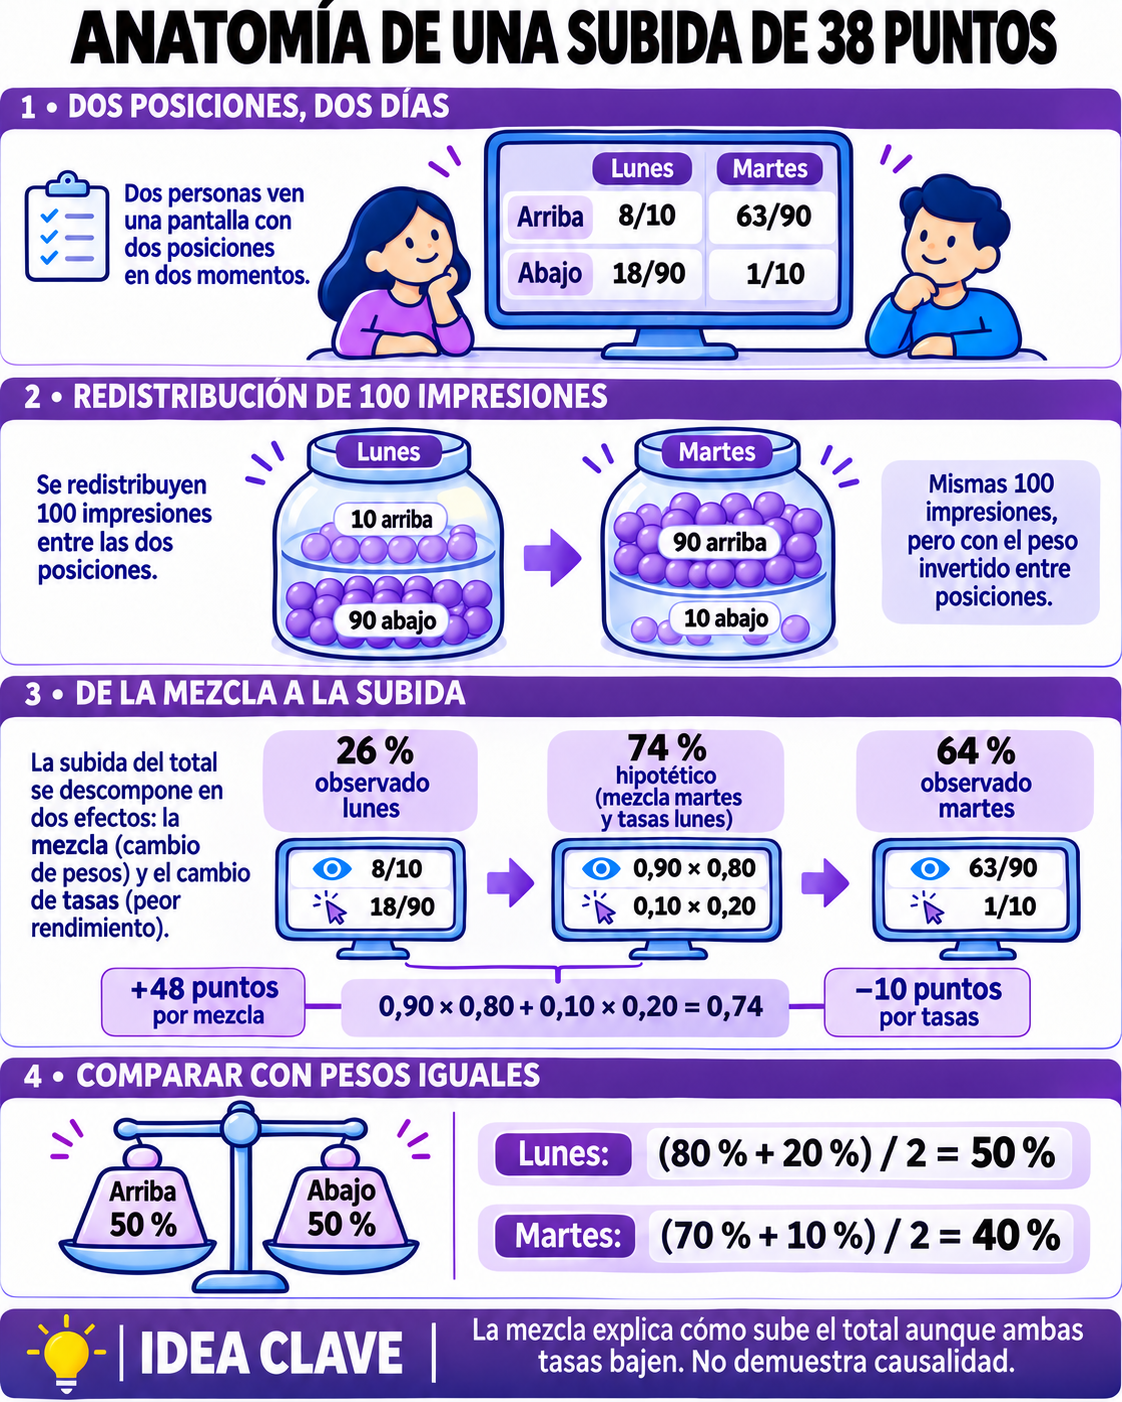 Figura 2. Con las tasas del lunes y la mezcla del martes se obtiene 74 %. Si solo cambia dónde aparecen las miniaturas, la tasa gana 48 puntos. Al incorporar la caída dentro de cada posición, pierde diez.
¿Cómo se ganan 38 clics por cada cien impresiones si las dos posiciones empeoran? El lunes solo 10 de las 100 impresiones aparecieron arriba; el martes fueron 90. Como arriba se hacía clic con más frecuencia, ese cambio de reparto podía elevar el total. Veamos cuánto explica.
1. Cambia solo el reparto. Imagina un martes en el que cada posición conserva su tasa del lunes. Mantén las tasas del lunes (80 % arriba y 20 % abajo), pero reparte las impresiones como el martes (90 arriba y 10 abajo). De las cien impresiones, esperarías este número con clic:
\[90\times0{,}80+10\times0{,}20=72+2=74\]
Ese 74 % es hipotético. Frente al 26 % observado el lunes, son 48 puntos más por el cambio de reparto.
2. Cambia ahora las tasas. Con esas mismas 90 impresiones arriba y 10 abajo, aplica ahora las tasas reales del martes. Obtienes el 64 % observado: diez puntos menos que en el cálculo anterior. Ya podemos explicar la subida: los 48 puntos que aporta el reparto compensan los 10 que se pierden dentro de las posiciones. Quedan 38 puntos de subida total. Ese aumento, por sí solo, no demuestra que el recomendador haya mejorado.
3. Compara con el mismo reparto. Ahora la pregunta es otra: si el lunes y el martes hubieran tenido las mismas oportunidades de conseguir clics arriba y abajo, ¿qué día habría obtenido la tasa más alta? Prueba con cincuenta impresiones en cada posición. El lunes esperarías 40 clics arriba y 10 abajo; el martes, 35 arriba y 5 abajo. La diferencia es de diez puntos. ¿Depende de haber elegido mitad y mitad? Llamemos \(q\) a la proporción de impresiones que ponemos arriba y \(1-q\) a la que queda abajo. Esta es la diferencia entre los dos días:
\[q(0{,}70-0{,}80)+(1-q)(0{,}10-0{,}20)=-0{,}10.\]
Arriba, la tasa de clic pasó del 80 % al 70 %; abajo, del 20 % al 10 %. El martes perdió diez puntos en las dos posiciones. Por eso, si usas el mismo reparto para ambos días, la diferencia siempre es la misma: diez impresiones con clic menos por cada cien el martes. Puedes comprobarlo con el deslizador.
LABORATORIO · REPARTE 100 IMPRESIONESImagina 100 impresiones cada día. Tú eliges cuántas van arriba; el resto va abajo. El reparto es el mismo para lunes y martes. Lo que cambia de un día al otro son las tasas de la tabla: arriba recibió clic el 80 % el lunes y el 70 % el martes; abajo, el 20 % y el 10 %, respectivamente.
Para cada día, multiplica las impresiones de cada posición por su tasa de clic y suma las dos cantidades. Como partimos de 100 impresiones, el número esperado con clic también indica el porcentaje.
Lunes
Martes
Prueba a pasar de 50 a 60 impresiones arriba. Esas diez impresiones pasan de una posición con menos clics a otra con más. El lunes ganarías 8 arriba y perderías 2 abajo; el martes ganarías 7 y perderías 1. Ambos totales suben 6 puntos. Por eso la distancia entre los días sigue siendo de diez puntos.
Qué aprende un modelo que predice un solo número
Si el modelo da la misma probabilidad de clic a todas las miniaturas, ¿qué valor le conviene elegir? Llamemos \(p\) a su predicción y \(\mu\) a la proporción de impresiones con clic. La primera fórmula calcula el coste medio de predecir \(p\); la segunda es su derivada y nos dice cómo cambia el coste al mover esa predicción.
01 · Pérdida esperada\[L(p)=-\mu\ln p-(1-\mu)\ln(1-p).\]02 · Pendiente respecto a la probabilidad\[L'(p)=-\frac{\mu}{p}+\frac{1-\mu}{1-p}=\frac{p-\mu}{p(1-p)}.\]
El ejemplo del martes. Hubo 64 impresiones con clic y 36 sin clic. El modelo asignó probabilidad \(p\) al clic y \(1-p\) a la ausencia de clic. Por eso el coste \(-\ln p\) entra 64 veces en la suma y el coste \(-\ln(1-p)\), 36 veces. Dividimos entre las 100 impresiones para obtener la media:
\[L(p)=\frac{64[-\ln p]+36[-\ln(1-p)]}{100}.\]
1. Calcula el coste. En la fórmula general del coste, \(L(p)\) es la penalización media y \(\ln\) es el logaritmo natural. La proporción \(\mu\) multiplica el coste de los clics; el resto, \(1-\mu\), multiplica el de las impresiones sin clic. Por ejemplo, si alguien pulsa y el modelo apenas daba un 1 % de probabilidad al clic, el coste de ese clic es alto. Si daba un 90 %, el mismo clic cuesta menos:
\[-\ln(0{,}01)\approx4{,}61\qquad -\ln(0{,}90)\approx0{,}11\]
2. Lee la pendiente. La segunda línea da la pendiente: indica si el coste sube o baja al aumentar un poco la predicción. Para \(0<p<1\), el denominador es positivo. Basta mirar el signo de \(p-\mu\): si has predicho menos clics de los que hubo, subir la predicción reduce el coste; si has predicho más, lo aumenta. El mínimo está en \(p=\mu\). Con todas las impresiones del martes contando por igual, el modelo aprende \(0{,}64\). Con el mismo peso para las dos posiciones, aprende \(0{,}40\). 4,5,6
Si anuncio un 50 % de clic, ¿me conviene subir o bajar?El martes ya pasó: hubo 64 impresiones con clic y 36 sin clic. Imagina que tienes que puntuar dos pronósticos para esas mismas impresiones: uno decía «50 % de probabilidad de clic» y el otro, «51 %». ¿Cuál recibe menos penalización?
En la curva violeta, ir a la derecha significa anunciar más probabilidad de clic; estar más abajo significa recibir menos penalización. Mira el punto amarillo: es el pronóstico que estás probando. La recta amarilla toca la curva ahí y sigue su inclinación en ese punto. Esa es la tangente. Si al leerla hacia la derecha baja, te dice que subir un poco el pronóstico reduce el coste.
Prueba ahora el 80 %: anuncias más clics de los que hubo y conviene bajar el pronóstico. En el 64 % la curva llega al fondo. Has encontrado el mejor pronóstico único para estos datos; mover el deslizador no cambia cuánta gente hizo clic.
3. Comprueba qué aprende. ¿Cómo comprobarías que el entrenamiento está usando esos pesos? Si empieza prediciendo \(p=0{,}5\), un clic y un «sin clic» reciben exactamente la misma penalización, \(\ln 2\). Mirar solo ese primer coste no te dirá si los pesos cambiaron. Mira hacia qué predicción se mueve el modelo: ¿hacia 0,64 o hacia 0,40? scikit-learn permite asignar esos pesos al calcular la pérdida.
Hay otra comprobación distinta: de cada cien miniaturas a las que el modelo asigna un 64 %, ¿cuántas reciben clic? En el conjunto del martes acertaría el promedio. Si separas las posiciones, arriba recibieron clic el 70 % y abajo el 10 %. Esa comparación entre lo anunciado y lo observado se llama calibración. Acertar el promedio de ayer tampoco garantiza acertar mañana. 17,20
Cómo evaluar un vídeo que no se mostró
En una impresión concreta, el recomendador podía enseñar el vídeo A o el B. Enseñó A y la persona siguió de largo. ¿Qué escribirías en el registro? Para A, «sin clic». Para B, «no se mostró». Si escribes cero en los dos, estás diciendo que la persona rechazó un vídeo que nunca vio.
¿Qué podemos averiguar entonces? No sabremos qué habría hecho esa persona con B. Sí podemos usar otras impresiones comparables en las que B tuvo oportunidad de aparecer. La pregunta pasa a ser: «De cada cien recomendaciones, ¿cuántas esperaríamos que recibieran clic si ofreciéramos B más a menudo?».
1. Lee lo que se observó. En este ejemplo, el sistema sorteaba qué vídeo enseñar en la misma posición: A tenía un 98 % de probabilidad y B, un 2 %. En cien impresiones salieron 98 veces A y dos veces B. A recibió 49 clics; B, uno. En ambos casos hubo clic en la mitad de las impresiones, aunque para B esa mitad descansa en un solo clic.
2. Cambia la regla del sorteo. Queremos estimar qué pasaría si A apareciera el 80 % de las veces y B el 20 %. Seguimos hablando de espectadores y condiciones comparables. Para que el registro antiguo represente el nuevo reparto, cada observación recibe un peso: dividimos la probabilidad nueva de mostrar ese vídeo entre la que tenía cuando se registró.
\[w_A=\frac{0{,}80}{0{,}98},\qquad w_B=\frac{0{,}20}{0{,}02}=10.\]
El único clic en B representa diez clics ponderados porque la nueva regla ofrecería B diez veces más a menudo. Los 49 clics en A pasan a representar 40 porque A aparecería menos. Sumamos y dividimos entre las cien impresiones originales, incluidas las que terminaron sin clic:
\[\frac{49\,(0{,}80/0{,}98)+1\,(0{,}20/0{,}02)}{100}=\frac{40+10}{100}=50\,\%.\]
Ese 50 % es una estimación para la nueva regla. No hemos observado cien impresiones con ella.
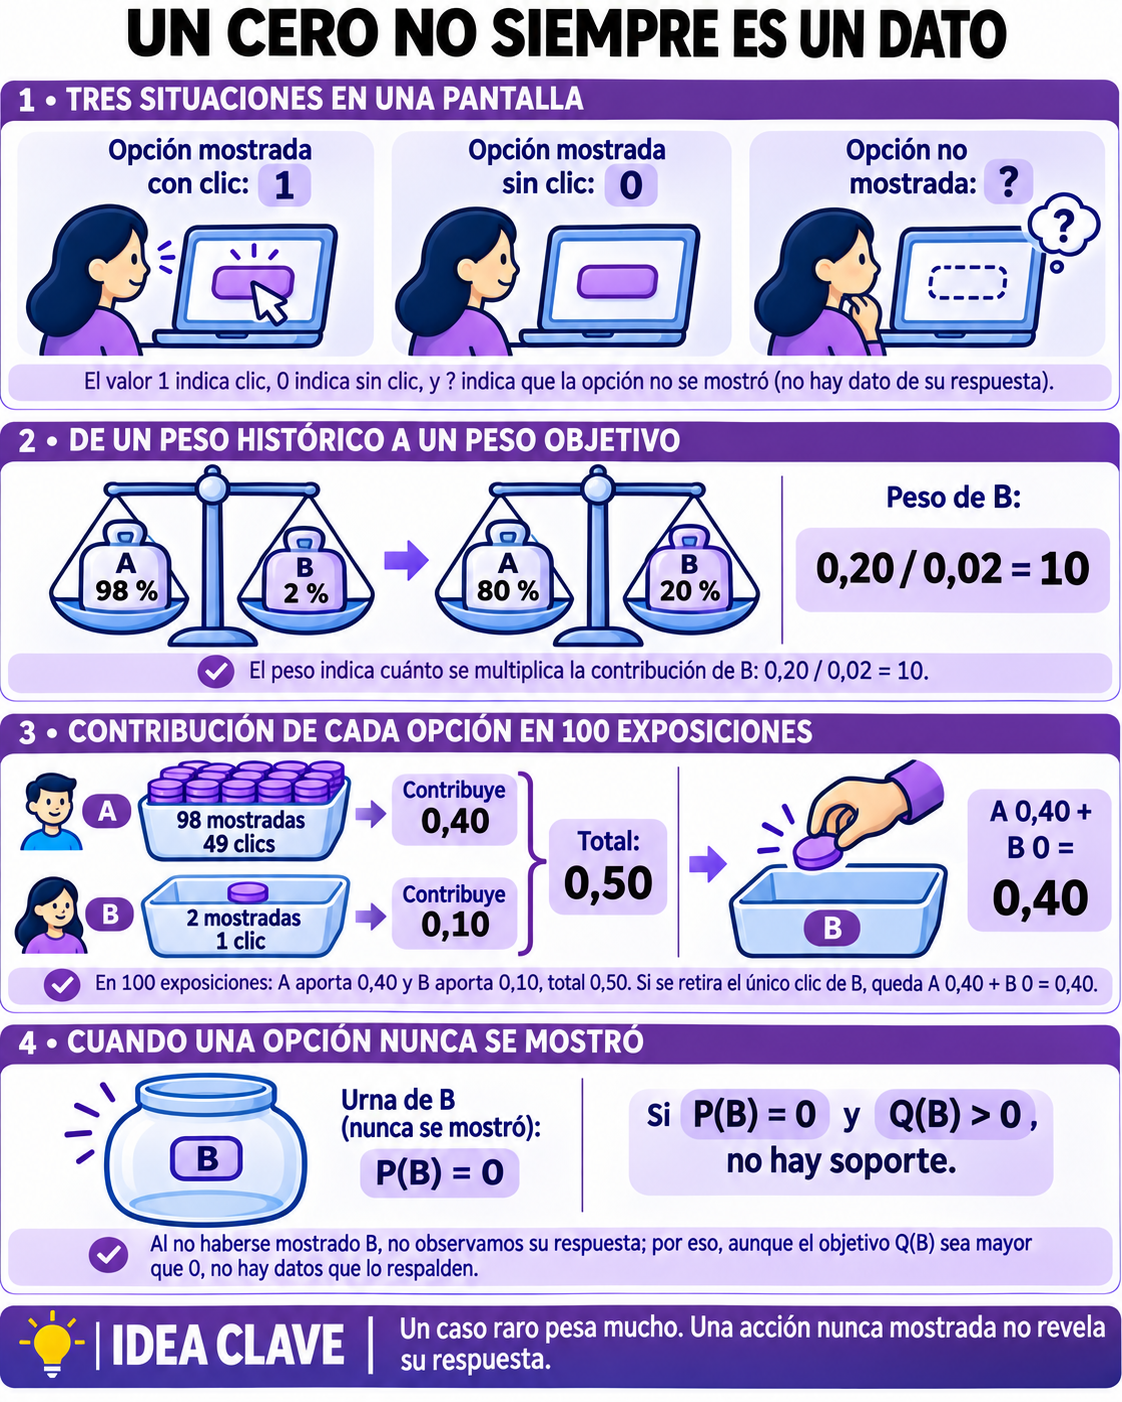 Figura 3. En 100 exposiciones, \(A\) aporta 0,40 y \(B\) 0,10 al estimador. Cambiar un clic de \(B\) mueve la estimación del 50 al 40 %. Si la política histórica nunca muestra \(B\), el cociente no está definido.
3. Mira cuánto depende de un solo clic. Vuelve a las dos veces que apareció B. Si nadie hubiera pulsado en ninguna, su aportación bajaría de diez a cero. La estimación pasaría del 50 % al 40 % por una sola respuesta distinta. Dar más peso a B corrige el reparto, pero no aporta más ejemplos de cómo responde la gente.
¿Y si la regla anterior nunca hubiera permitido mostrar B en esa situación? En el denominador del peso de B tendríamos cero. Eso es falta de soporte: ninguna impresión del registro puede decirnos cómo funcionaría B ahí. Haría falta recoger observaciones en las que sí pudiera mostrarse. 11
¿Qué le diría al equipo? «El martes hubo 38 impresiones con clic más por cada cien. Pero mostramos muchas más recomendaciones arriba. Si damos a cada posición el mismo peso los dos días, pasamos del 50 % al 40 %. El aumento del total no demuestra que el recomendador haya mejorado».
Para decidir si mantener el cambio, compararía las dos reglas en condiciones equivalentes y guardaría, por cada impresión, qué vídeos podían mostrarse, cuál se eligió, con qué probabilidad, en qué posición y si hubo clic. Antes de la prueba acordaría qué significa una buena recomendación: si la persona abre el vídeo y lo cierra dos segundos después, el registro contará un clic. ¿Es ese el resultado que queríamos mejorar? 18
Referencias
- Berná, P. M. (s. f.). [Diapositivas de la unidad 1 sobre recomendación y espacios de probabilidad] (diaps. 9 y 23). UTAMED.
- Covington, P., Adams, J., & Sargin, E. (2016). Deep neural networks for YouTube recommendations. En Proceedings of the 10th ACM Conference on Recommender Systems (pp. 191–198). ACM. https://research.google.com/pubs/archive/45530.pdf
- Dudik, M., Langford, J., & Li, L. (2011). Doubly Robust Policy Evaluation and Learning. arXiv. https://arxiv.org/abs/1103.4601
- Gilotte, A., Calauzènes, C., Nedelec, T., Abraham, A., & Dollé, S. (2018). Offline A/B testing for Recommender Systems. arXiv. https://arxiv.org/abs/1801.07030
- Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep learning. MIT Press. https://www.deeplearningbook.org/contents/mlp.html
- Guo, C., Pleiss, G., Sun, Y., & Weinberger, K. Q. (2017). On Calibration of Modern Neural Networks. arXiv. https://arxiv.org/abs/1706.04599
- Joachims, T., Swaminathan, A., & Schnabel, T. (2016). Unbiased Learning-to-Rank with Biased Feedback. arXiv. https://arxiv.org/abs/1608.04468
- Kahan, B. C., Blette, B. S., Harhay, M. O., Halpern, S. D., Jairath, V., Copas, A., & Li, F. (2024). Demystifying estimands in cluster-randomised trials. Statistical Methods in Medical Research, 33(7), 1211-1232. https://doi.org/10.1177/09622802241254197
- Kahan, B. C., Li, F., Blette, B., Jairath, V., Copas, A., & Harhay, M. O. (2023). Informative cluster size: A case study from the TRIGGER trial. Clinical Trials. https://doi.org/10.1177/17407745231186094 https://pmc.ncbi.nlm.nih.gov/articles/PMC10638852/
- Li, L., Chu, W., Langford, J., & Schapire, R. E. (2010). A Contextual-Bandit Approach to Personalized News Article Recommendation. arXiv. https://arxiv.org/abs/1003.0146
- Li, L., Chu, W., Langford, J., & Wang, X. (2010). Unbiased Offline Evaluation of Contextual-bandit-based News Article Recommendation Algorithms. arXiv. https://arxiv.org/abs/1003.5956
- Lipton, Z. C., Wang, Y., & Smola, A. (2018). Detecting and Correcting for Label Shift with Black Box Predictors. arXiv. https://arxiv.org/abs/1802.03916
- Massachusetts Institute of Technology. (2010). Probabilistic systems analysis and applied probability [Diapositivas]. MIT OpenCourseWare. https://ocw.mit.edu/courses/6-041-probabilistic-systems-analysis-and-applied-probability-fall-2010/60eede37f87fd886d4ba574e1cf26617_MIT6_041F10_lec_slides.pdf
- Ng, A., & Ma, T. (2022). CS229 lecture notes. Stanford University. https://cs229.stanford.edu/notes2022fall/main_notes.pdf
- Owen, A. B. (2013). Monte Carlo theory, methods and examples [Manuscrito]. https://artowen.su.domains/mc/Ch-var-is.pdf
- Schaul, T., Quan, J., Antonoglou, I., & Silver, D. (2015). Prioritized Experience Replay. arXiv. https://arxiv.org/abs/1511.05952
- Schnabel, T., Swaminathan, A., Singh, A., Chandak, N., & Joachims, T. (2016). Recommendations as Treatments: Debiasing Learning and Evaluation. arXiv. https://arxiv.org/abs/1602.05352
- scikit-learn developers. (s. f.). log_loss. scikit-learn. https://scikit-learn.org/stable/modules/generated/sklearn.metrics.log_loss.html
- SQLite. (s. f.). Built-in aggregate functions. https://www.sqlite.org/lang_aggfunc.html
- Sugiyama, M., Krauledat, M., & Müller, K.-R. (2007). Covariate shift adaptation by importance weighted cross validation. Journal of Machine Learning Research, 8, 985–1005. https://www.jmlr.org/papers/volume8/sugiyama07a/sugiyama07a.pdf
- Swaminathan, A., & Joachims, T. (2015). Counterfactual Risk Minimization: Learning from Logged Bandit Feedback. arXiv. https://arxiv.org/abs/1502.02362
- UTAMED. (s. f.). Fundamentos matemáticos para la inteligencia artificial (unidad 1, §2.1, pp. 7–8).
- Zhang, A., Lipton, Z. C., Li, M., & Smola, A. J. (2023). Dive into deep learning. Cambridge University Press. https://d2l.ai/chapter_linear-classification/softmax-regression.html
Glosario
Consultar símbolos y términos
- \(\Omega,\mathcal F,P\) · Espacio de probabilidad
- En el sorteo de la tabla, \(\Omega\) contiene las cuatro filas posibles. Un suceso es un grupo de esas filas, como «la miniatura apareció arriba». \(\mathcal F\) recoge los sucesos que distinguimos y \(P\) asigna una probabilidad a cada uno.
- \(C^{\mathrm c}, A\cap C, A\cup C\)
- \(C^{\mathrm c}\) reúne las tres filas sin clic. \(A\cap C\) pide «arriba y con clic»: solo la primera fila. \(A\cup C\) pide «arriba o con clic», incluida la posibilidad de que ocurran ambas cosas: en esta tabla son las filas 1 y 2.
- \(P(C\mid A)\) · Condicionamiento
- Se lee «probabilidad de clic sabiendo que la miniatura apareció arriba». Limita la cuenta a las dos filas de arriba: una tuvo clic, así que \(P(C\mid A)=1/2\). Esta división requiere que \(P(A)>0\).
- Impresión y tasa de clic
- Cada aparición de una miniatura cuenta como una impresión. La tasa de clic es la fracción de impresiones que recibieron al menos un clic: el martes, 64 de 100.
- Probabilidad total
- Para reunir las dos posiciones, multiplica la proporción de impresiones de cada posición por su tasa de clic y suma: el martes, 0,90 × 0,70 + 0,10 × 0,10 = 0,64.
- Estandarización
- Comparar los dos días dando el mismo peso a cada posición en ambos días. Si fijas la mitad de las impresiones arriba y la mitad abajo, obtienes un 50 % de clics el lunes y un 40 % el martes.
- Pérdida logarítmica · \(L(p)\)
- Penaliza una predicción según la probabilidad que asignó al resultado que ocurrió. Si anuncias un 1 % de clic y alguien pulsa, el coste es mucho mayor que si anuncias un 90 %. Aquí \(L(p)\) promedia ese coste sobre todas las impresiones.
- Pendiente y tangente · \(L'(p)\)
- La tangente es la recta que sigue la inclinación de la curva en el punto elegido; su pendiente indica cómo cambia el coste si subes un poco la predicción. Con los datos del martes, al 50 % baja y al 64 % queda horizontal: ahí el coste es mínimo.
- Calibración
- Si un modelo anuncia un 70 % de probabilidad de clic para muchas impresiones, ¿reciben clic unas siete de cada diez? Esa concordancia entre predicción y frecuencia observada se puede comprobar en toda la pantalla o por posición.
- Propensión y soporte
- La propensión es la probabilidad que tenía el sistema de mostrar un vídeo en una situación concreta. Si podía elegirlo, aunque fuera pocas veces, ese vídeo está en el soporte. Si nunca podía elegirlo, en ese contexto no tenemos respuestas observadas para él.
- Peso de una observación
- Para evaluar otra regla de recomendación, divide la probabilidad de mostrar ese vídeo con la regla nueva entre la que tenía con la anterior, en la misma situación. Si pasa del 2 % al 20 %, cada clic observado en ese vídeo pesa diez veces más.
- Dato ausente · NULL en la práctica SQL
- Cero clics en diez impresiones dan una tasa del 0 %. Si hubo cero impresiones, no hay una tasa que calcular. La consulta devuelve NULL para la comparación que necesita esa posición.
- Contrafactual
- El espectador vio el vídeo recomendado \(A\). ¿Habría pulsado si, en su lugar, le hubiéramos mostrado \(B\)? Esa respuesta alternativa es el resultado contrafactual. El registro solo recoge lo que pasó con la recomendación mostrada.
Datos de la entrada
- Origen
- El punto de partida fue el espacio de probabilidad del manual de UTAMED (unidad 1, §2.1). Al llevarlo al ejemplo de las recomendaciones, surgió la pregunta de la bitácora: ¿cómo puede subir la tasa de clics si baja en cada posición?
- Lectura estimada
- 19 minutos, sin contar el tiempo para explorar los simuladores o ejecutar el SQL.
- Narración
- 11 min 9 s. Corresponde a una versión anterior del texto.
- Idioma
- Español
- Modelos utilizados
- Texto: GPT-6 Astra (Codex).
Imágenes: ImageGen.
Audio: VoxCPM2, perfil D de Iván Carrillo. - Última revisión
- 3 de noviembre de 2026