Matemáticas aplicadas a la IA · Bitácora de estudio
¿Merece la pena instalar este sensor?
Antes de comprar un sensor, mide cuánto cambia lo que sabes sobre cada pieza al escuchar su alarma.
Contenido de la bitácora
Ensayo simulado para estudiar el concepto: las 80 piezas y las cuatro celdas se proponen aquí. Una fábrica puede medir la vibración de cada pieza antes de enviarla. El sensor devuelve «alarma» o «silencio». Una inspección posterior confirma «fallo» o «sin fallo». Antes de pagar otra instalación, quieres saber si la lectura reduce la incertidumbre sobre el resultado. La pregunta no es cuántas alarmas genera, sino qué cambia en lo que puedes anticipar después de oír una.
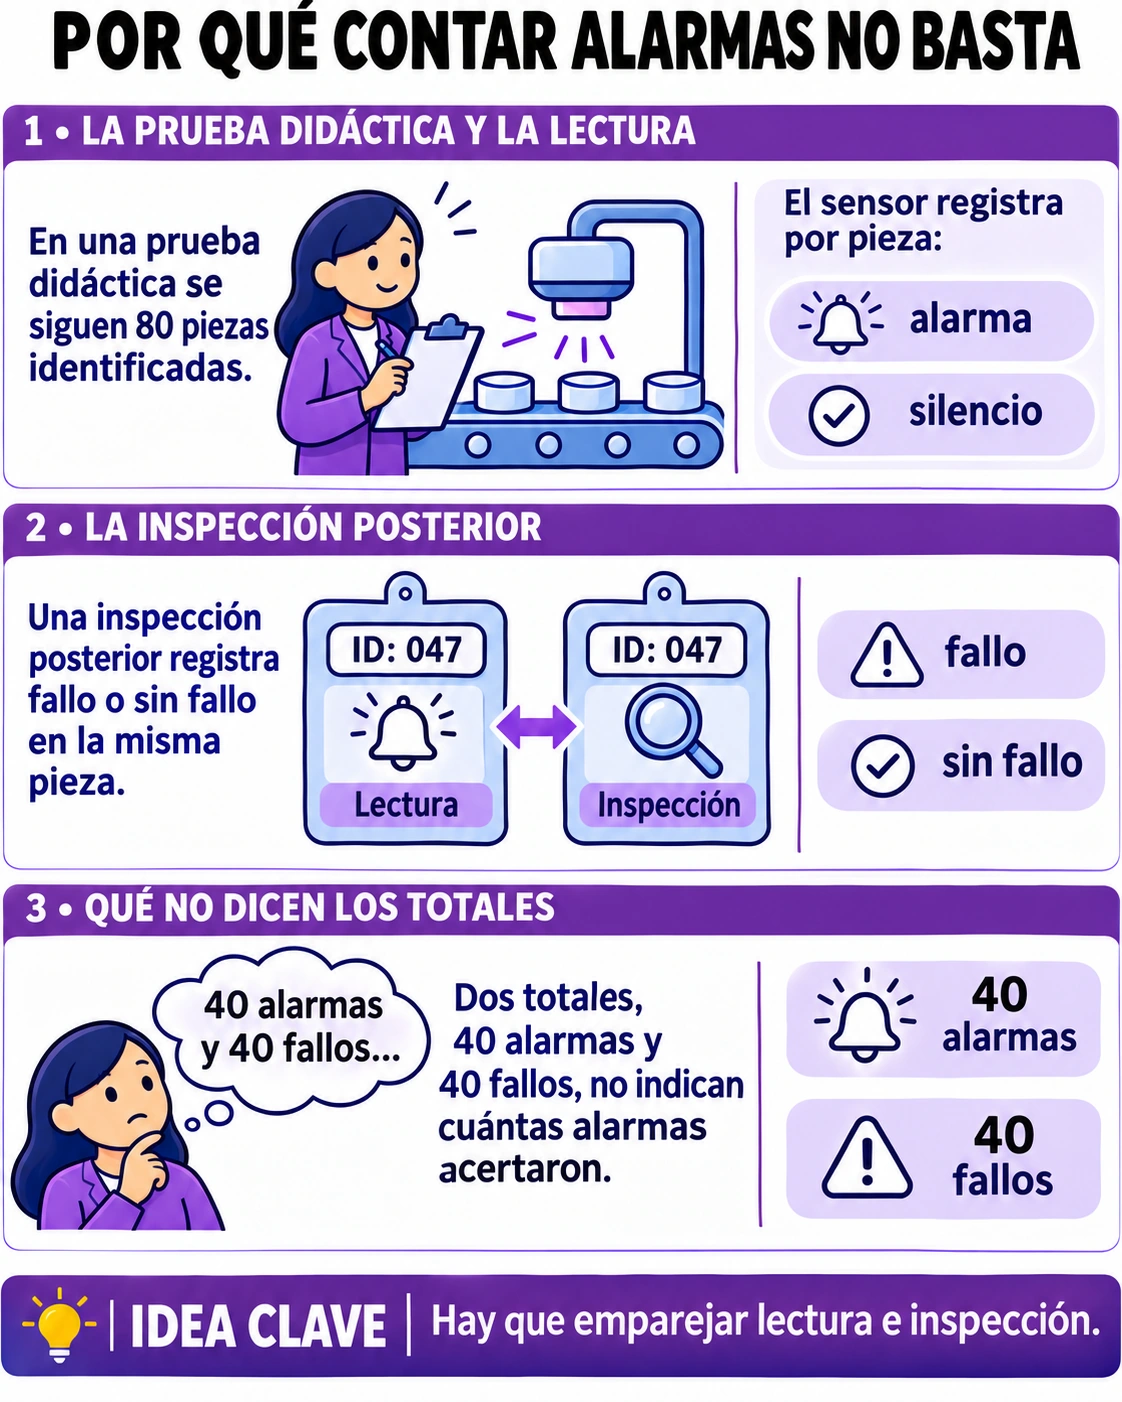
La información está en los pares
Imagina un ensayo didáctico con 80 piezas. El sensor avisa en 40. Hay 40 fallos confirmados. Esas dos cifras todavía no dicen nada sobre si las alarmas sirven: podrían corresponder exactamente a las piezas malas, a ninguna o a una mezcla al azar. Necesitas unir registros de sensor e inspección por pieza y contar cada combinación. [1]
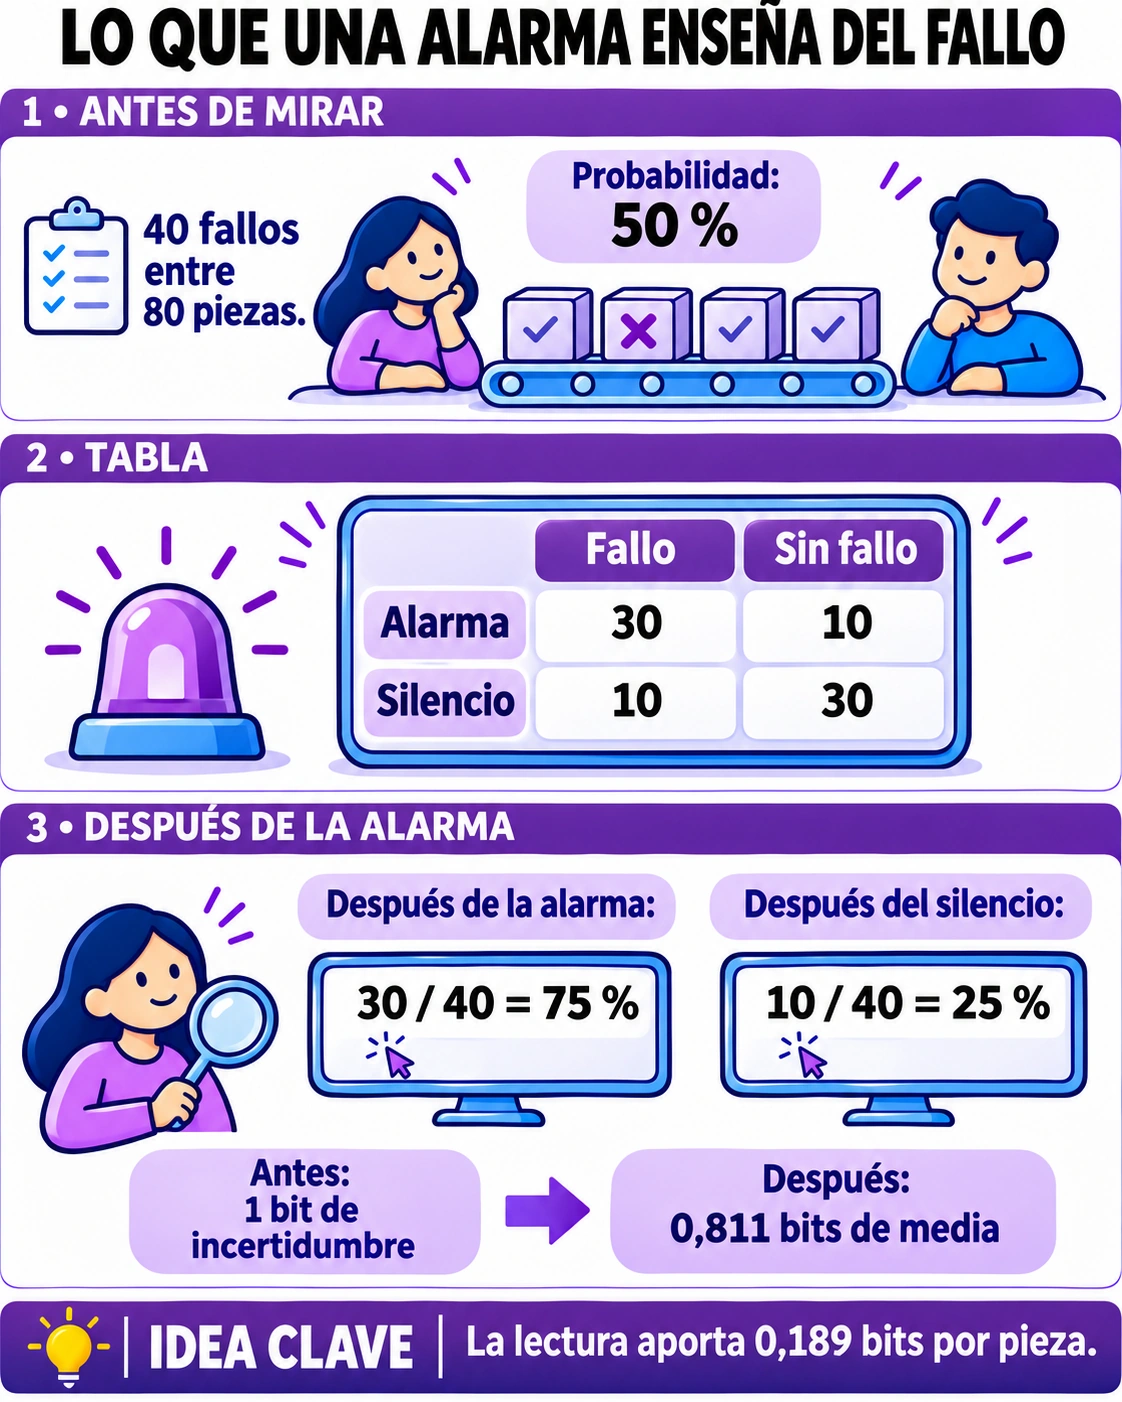
Antes de mirar el sensor, la probabilidad de fallo es un medio. La entropía de la etiqueta Y es un bit. Al oír la alarma, la proporción pasa a tres cuartos; tras el silencio cae a un cuarto. El grado de incertidumbre en cada rama coincide por simetría. En ambas es −0,75 log₂ 0,75 − 0,25 log₂ 0,25 ≈ 0,811 bits.
H(Y|X) = Σₓ P(x) H(Y|X=x)
X representa la señal. Esta expresión promedia las incertidumbres que te quedarían después de ver cada lectura posible, ponderadas por la frecuencia de esa lectura. En el ensayo las dos ramas pesan un medio, así que el promedio es 0,811 bits por pieza. La información mutua es la caída de incertidumbre media.
I(X;Y) = H(Y) − H(Y|X) ≈ 1 − 0,811 = 0,189 bits por pieza
El sensor no elimina el 18,9 % de los fallos. No hemos reparado ninguna pieza. Tampoco dice esta cifra qué precio pagar por el equipo. Mide cuánto cambia la distribución esperada de resultados al incorporar la lectura, en las condiciones y proporciones concretas de este ensayo.
Comprueba el mecanismo
Conserva los márgenes: 80 piezas, 40 alarmas y 40 fallos. Cuando cambia el recuento de una casilla, se compensan las demás. Prueba 20, después 10 y 30.
La otra fórmula pregunta lo mismo
Si X e Y fueran independientes, la probabilidad de cada par sería el producto de las probabilidades marginales. Con nuestras proporciones, cualquier casilla tendría probabilidad 0,5 × 0,5 = 0,25. En realidad, la casilla «alarma y fallo» tiene probabilidad 30/80 = 0,375. El cociente 0,375/0,25 = 1,5 compara lo observado con la independencia. La información mutua resume los logaritmos de esos cocientes ponderados por la probabilidad conjunta real. [12]
I(X;Y) = Σₓ,ᵧ P(x,y) log₂ [P(x,y) / (P(x)P(y))]
Las otras casillas contienen las probabilidades 0,125, 0,125 y 0,375. Dos cocientes son 1,5 y dos son 0,5. El cálculo queda 2 × 0,375 log₂ 1,5 + 2 × 0,125 log₂ 0,5 ≈ 0,189. Algunos términos individuales son negativos: esas combinaciones aparecen menos de lo esperado bajo independencia. La suma nunca es negativa. En la población vale cero exactamente cuando las variables son independientes.
Una señal buena puede ser redundante
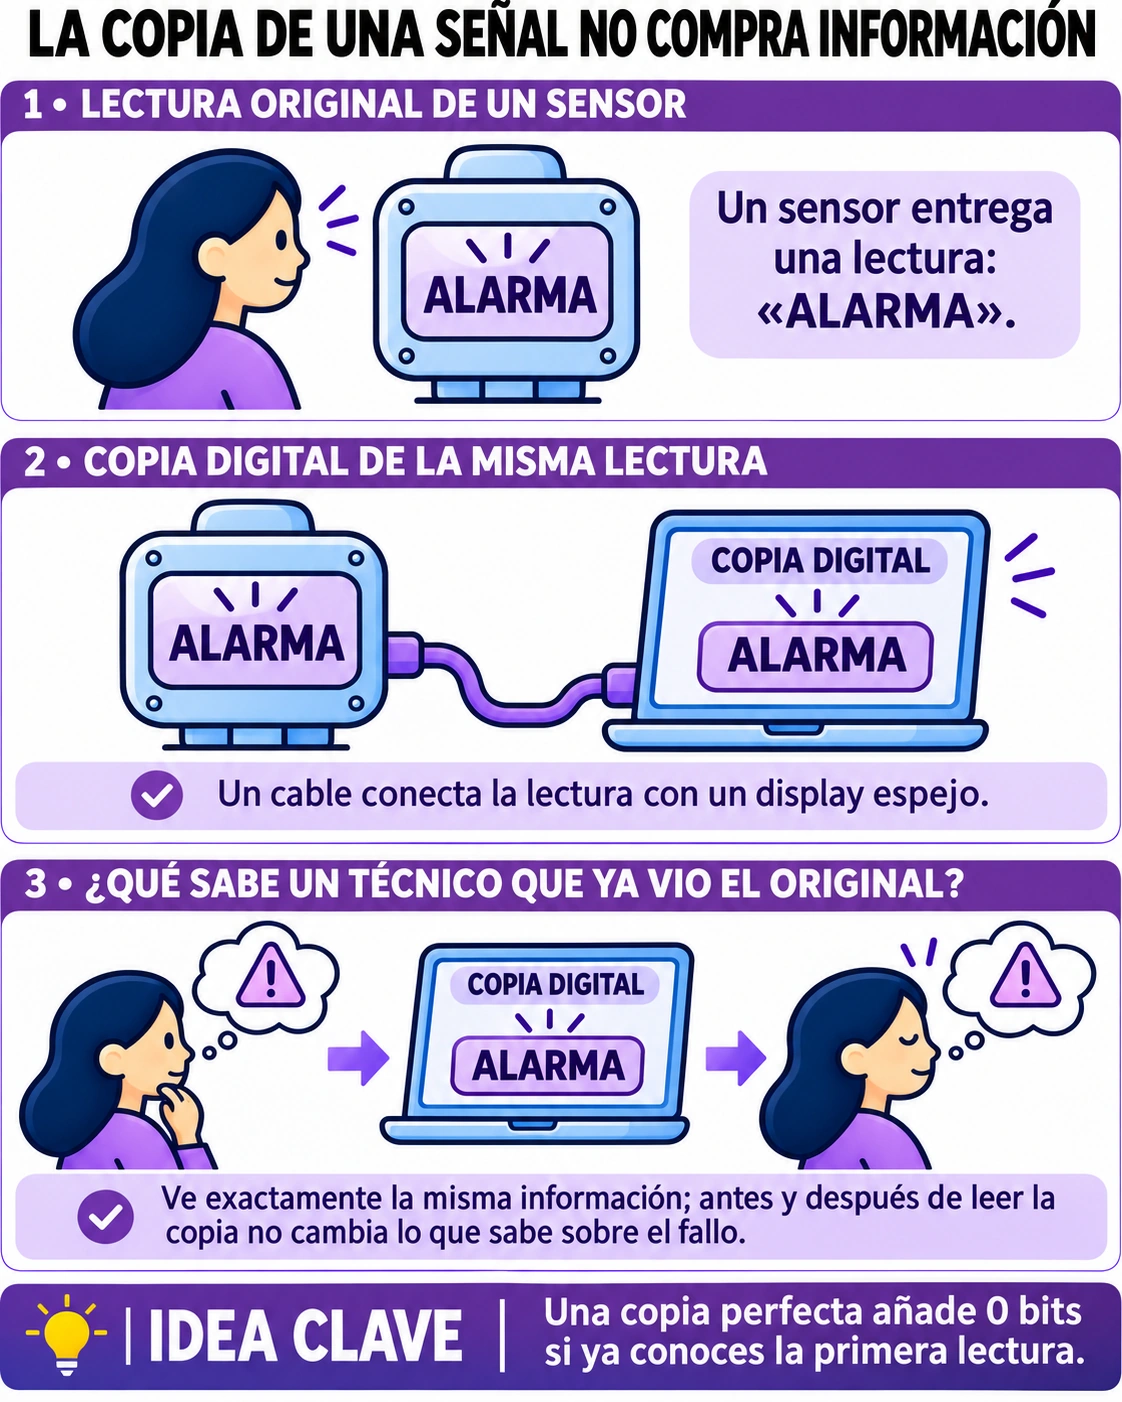
Ahora imagina que el proveedor ofrece un segundo sensor con una lectura que coincide siempre con el primero. Obtendrá los mismos 0,189 bits si lo evalúas a solas. Sin embargo, una vez conocida la primera lectura, conocer su copia no reduce la incertidumbre restante. Ordenar columnas por sus puntuaciones individuales y comprar las dos primeras desperdiciaría presupuesto. Compara la ganancia adicional después de lo que ya sabes. [2]
También puede ocurrir lo contrario. Supón dos interruptores justos e independientes y una máquina que falla únicamente cuando sus estados son distintos. Si solo te dicen que el primero está encendido, sigues sin saber si habrá fallo: depende del segundo. Cada interruptor por separado comparte cero bits con la etiqueta. Los dos juntos determinan el resultado y eliminan un bit entero de incertidumbre. Este pequeño contraejemplo explica por qué eliminar automáticamente toda variable con puntuación individual baja puede borrar una interacción útil.
Pasar del cálculo al ensayo de compra
Define primero la población. Si el ensayo eligió deliberadamente tantas piezas malas como buenas, su tasa de fallos no representa la línea real. Al cambiar las proporciones cambian la entropía inicial y la información mutua, incluso si el sensor conserva sensibilidad y especificidad. Para anticipar la operación, evalúa un tramo futuro con el reparto natural de piezas, lotes y máquinas. Si las lecturas son continuas, tampoco basta con crear una casilla por valor: discretizar de distintas maneras puede alterar el resultado. [17]
Para comprobar si una señal aparente puede explicarse por el tamaño de muestra, desordena las etiquetas manteniendo las lecturas y vuelve a calcular. Compara la puntuación real con muchas permutaciones que respeten el diseño del muestreo. Si hay varias piezas del mismo lote, una permutación arbitraria puede romper la dependencia por lote y exagerar la evidencia. El objetivo no es encontrar un umbral universal en bits; es contrastar la señal observada con un escenario sin asociación apropiado.
Prueba de transferencia
Conserva las 40 alarmas, los 40 fallos y las 80 piezas. Cambia los cuatro recuentos a 20, 20, 20 y 20. ¿Qué habrá cambiado?
Comprobar razonamiento
La frecuencia de cada lectura y la de cada etiqueta permanecen iguales. La probabilidad de fallo dentro de cada rama vuelve al 50 %. Conocer la lectura deja un bit de incertidumbre, igual que antes de observarla: I = 0. La asociación depende de la tabla conjunta, no solo de sus totales.
Decisión
Una señal de 0,189 bits en este ensayo merece comprobarse fuera de la muestra; no demuestra que el sensor cause fallos ni que resulte rentable. Para una decisión de compra pide el coste, las consecuencias de una alarma falsa y de una pieza defectuosa no detectada, y compara una política con sensor y otra sin él sobre la misma producción. [15]
Qué comprobar al pasar de una tabla a datos de planta
Para que la tabla represente una predicción real, la lectura debe existir antes de la decisión. Si la columna alarma se rellena a partir del informe de inspección final, el sensor parecerá maravilloso: la misma información se habrá usado para generar predictor y etiqueta. Llama a este problema fuga de información y verifica las marcas de tiempo. Una dependencia muy elevada puede ser justo la señal de que estás midiendo algo que no estará disponible cuando toque actuar.
Otra comprobación es la unidad de muestreo. Si tomas cien lecturas del mismo motor durante un único minuto y cada una hereda la misma etiqueta, no tienes cien experimentos independientes sobre motores distintos. La tabla puede describir los pares de registros, pero la incertidumbre sobre su capacidad de generalizar a otras máquinas será mayor de lo que sugiere el recuento de filas. Divide por lote o por motor si esa es la unidad que deberá generalizar. En un experimento temporal, compara un tramo de desarrollo con otro posterior.
Si mañana cambia el equilibrio entre fallos y piezas correctas, no traslades directamente el 0,189. Escribe sensibilidad y tasa de falsa alarma como probabilidades de señal condicionadas a la etiqueta; después combínalas con la nueva frecuencia de fallos para reconstruir la distribución conjunta de operación. Cambiar una marginal y conservar el resto de la tabla tal cual no garantiza que los márgenes vuelvan a sumar uno. Cada probabilidad condicional necesita nombrar su denominador.
Por último, fija qué umbral convierte el voltaje en alarma. Si eliges el corte explorando todas las etiquetas y luego comunicas los bits en las mismas piezas, has seleccionado la mejor fluctuación de esa muestra. Divide primero los datos. Aprende el umbral con la parte de desarrollo, congélalo y calcula la tabla en datos retenidos. Si la evaluación revela un sensor mediocre no es un fracaso del cálculo: acabas de evitar una compra apoyada en una señal exagerada.
La misma información, un significado opuesto
Hay otra razón para no convertir una puntuación en una política automática. Una señal puede ser igual de informativa si avisa de un fallo y si avisa de una pieza correcta. La información mutua no privilegia el nombre «alarma»: mira si el reparto de etiquetas cambia. Con los márgenes del ensayo, compara las tablas con 30, 20, 10 y cero fallos en el grupo de las alarmas. Si ajustas la máquina para descartar automáticamente una pieza cuando oye la señal, los escenarios de 30 y 10 no son intercambiables, aunque comparten el mismo número de bits.
Guárdalo como practica.py y ejecuta python3 practica.py en una terminal. También puedes pegar el bloque en una celda de Jupyter y pulsar Mayús + Intro.
from math import log2

def i_tabla(a):
    # Márgenes fijos a 40; N = 80. Independencia: 20 por celda.
    celdas = [a, 40-a, 40-a, a]
    return sum((n/80)*log2(n/20) for n in celdas if n)

for a in [30, 20, 10, 0]:
    print(a, round(i_tabla(a), 3))
Salida comprobada
30 0.189
20 0.0
10 0.189
0 1.0
Cuando a vale cero, el sensor nunca da alarma ante una pieza defectuosa y siempre da alarma ante una pieza correcta. Su lectura determina la etiqueta con total certeza y el resultado es un bit. La regla «alarma implica fallo» saldría fatal; la regla inversa acertaría todos los casos del ejemplo. La puntuación no ha fallado: cuantifica dependencia, no su dirección ni la utilidad monetaria de una decisión. Prueba el extremo 40 y comprueba que encuentras otro bit perfecto con sentido operativo contrario.
Glosario de esta entrada
- Distribución conjunta
- Probabilidad de cada par señal y etiqueta.
- Marginal
- Distribución de una variable sin condicionar en la otra.
- Condicionada
- Distribución de resultados dentro de una lectura específica.
Origen y edición
Manual §6.2–6.3, pp. 31–33 · Diapositivas 80–81. Material de Matemáticas aplicadas a la IA y al Deep Learning (UTAMED). Los datos de los casos son hipotéticos y las preguntas sirven para practicar; no proceden de un examen.
Edición en español · 4 de noviembre de 2026. Texto asistido por Codex; infografías de ImageGen.
Lecturas contrastadas
Estas veinte obras y documentos se consultaron para preparar la explicación. La nota indica qué pregunta ayuda a resolver cada uno. El expediente distingue los pasajes de las obras y los resúmenes accesibles; no presupone lectura íntegra de todos los originales.
Descargar expediente de investigación
- Conditional Likelihood Maximisation: A Unifying Framework for Information Theoretic Feature SelectionOrganiza las diferencias entre relevancia marginal y relevancia condicionada.
- Fast Binary Feature Selection with Conditional Mutual InformationSelecciona con información mutua condicional para evitar duplicar señales.
- mutual_info_classif — scikit-learn 1.9.1 documentationAclara qué estimador usa la API y en qué unidad devuelve el resultado.
- A Mutual Information estimator for continuous and discrete variables applied to Feature Selection and Classification problems | International Journal of Computational Intelligence Systems | Springer Nature LinkSelecciona estimadores según la combinación de variables discretas y continuas.
- Reconsidering Mutual Information Based Feature Selection: A Statistical Significance View | Proceedings of the AAAI Conference on Artificial IntelligenceSepara el tamaño de una estimación y su evidencia frente al azar.
- A New Perspective for Information Theoretic Feature SelectionRelaciona las aproximaciones por pares con interacciones entre características.
- Feature Selection with Conditional Mutual Information Considering Feature InteractionAnaliza señales cuya contribución cambia al conocer otras variables.
- FEAST for C, Java and MATLABContrasta varios criterios de filtro con una misma implementación pública.
- Marx, Yang y van Leeuwen · Estimating Conditional Mutual Information for Discrete-Continuous Mixtures using Multi-Dimensional Adaptive HistogramsEstudia cómo construir histogramas adaptativos al estimar información mutua condicional en datos mixtos; los intervalos son una decisión del estimador.
- Jointly Informative Feature SelectionInvestiga selecciones basadas en grupos de variables informativas en conjunto.
- The Role of Mutual Information Estimator Choice in Feature Selection: An Empirical Study on mRMRContrasta la sensibilidad del orden de variables al estimador utilizado.
- Estimating mutual information | Phys. Rev. EDesarrolla estimadores para observaciones continuas mediante vecinos cercanos.
- Jointly Informative Feature Selection Made TractableCompara selección conjunta y clasificación de variables una a una.
- Theoretical Evaluation of Feature Selection Methods based on Mutual InformationExplicita los supuestos bajo los que dos criterios seleccionan diferentes variables.
- Resampling methods for parameter-free and robust feature selection with mutual informationIntroduce remuestreo para estimar la estabilidad de una selección.
- Feature Selection via L1-Penalized Squared-Loss Mutual InformationContrasta selección conjunta y redundancia de características.
- Mutual Information between Discrete and Continuous Data Sets | PLOS OneAclara el caso mixto de una lectura continua y una etiqueta discreta.
- Mutual Information Neural EstimationDemuestra que estimar en alta dimensión requiere supuestos y técnicas distintas de contar una tabla.
- Learning to Maximize Mutual Information for Dynamic Feature SelectionEstudia cómo una lectura previa cambia qué característica merece la pena adquirir.
- Estimating Mutual Information in Under-Reported VariablesEl subregistro de eventos altera las asociaciones observables.