Son las nueve y el taller tiene una sola plaza libre antes del mediodía. Acaba de entrar una máquina con una vibración que el sistema de mantenimiento no reconoce. La encargada abre el historial: «¿Qué hicimos las últimas veces que vimos algo parecido?». Ese gesto contiene la idea de los vecinos más próximos. Para convertirlo en una regla que dos personas puedan reproducir, faltan tres decisiones: qué significa «parecido», a cuántos precedentes vamos a escuchar y qué hacemos si discrepan.
Una avería nueva, tres precedentes
Trabajemos con un historial hipotético. Cada fila representa una orden de reparación cerrada. Para comparar las órdenes solo usamos información disponible cuando entran: vibración, antigüedad de la máquina y tiempo desde la última revisión. La etiqueta histórica sí la conocemos después de inspeccionar: había que actuar con urgencia o se podía mantener el turno normal. Usar casos anteriores con una respuesta conocida hace de este ejemplo un problema de clasificación supervisada.
Supongamos que ya hemos elegido cómo combinar esas medidas y calculado la distancia de la orden nueva a cada precedente. El resultado es esta tabla. Fíjate en el significado de la columna central: es la distancia al pedido que acaba de entrar. No es la posición de cada cliente en una carretera ni la distancia al taller.
| Orden anterior | Distancia al pedido nuevo | Resultado de la inspección |
|---|---|---|
| A | 1 | Urgente |
| B | 2 | Normal |
| C | 3 | Normal |
Con un solo vecino, la respuesta es urgente. Con tres vecinos y un voto por vecino, gana normal por dos votos a uno. El conjunto de entrenamiento no ha cambiado; lo que ha cambiado es el tamaño del barrio. Se escribe k para indicar ese número de vecinos. Un k pequeño permite que una sola orden mal etiquetada cambie la predicción. Un k grande puede reunir averías que ya tienen poco que ver entre sí. Si escogieras como k el número total de órdenes, siempre ganarían las urgentes o las normales según cuál fuera la clase mayoritaria del taller entero. La máquina recién llegada habría dejado de influir en la decisión.

¿Tienen que pesar lo mismo los tres votos?
Volvamos a las órdenes A, B y C. Si consideramos que las muy parecidas ofrecen evidencia más útil, podemos asignar a cada vecino un peso inverso a la distancia. Llamamos d a la distancia y w al peso. Los pesos todavía no son probabilidades: por ahora son cantidades que podemos sumar para comparar las dos clases.
\[w_i=1/d_i\]
A recibe un peso de 1; B recibe 1/2, y C recibe 1/3. Sumando por clases, urgente reúne 1 y normal reúne 1/2 + 1/3 = 5/6. Ahora gana urgente. Si queremos expresar la fracción del peso que recibió esa clase, dividimos su peso entre el total:
\[\frac{1}{1+1/2+1/3}=\frac{6}{11}\approx 0{,}545.\]
Ese 54,5 % describe el reparto de peso bajo nuestra regla. Sería un salto interpretarlo directamente como frecuencia real de averías urgentes. Para sostener esa lectura necesitaríamos comprobar, en órdenes nuevas, con qué frecuencia resultan urgentes aquellas a las que el modelo asigna puntuaciones cercanas al 55 %. También habría que decidir cuánto cuesta dejar pasar una urgente frente a ocupar el único turno libre con una orden normal. Ni el voto ni sus decimales resuelven por sí solos esa decisión.
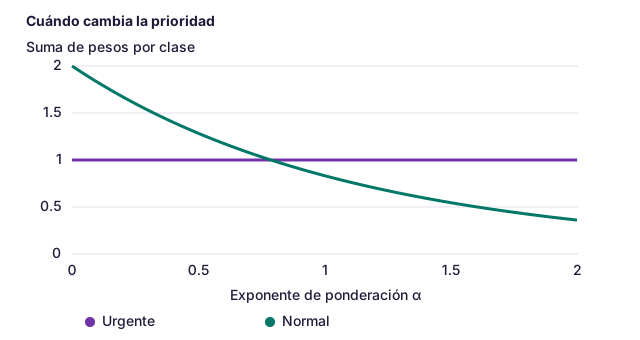
Hay un caso especial: dos máquinas pueden coincidir exactamente en las características observadas. Entonces d vale cero y la fórmula no se puede aplicar tal cual. Una regla explícita y reproducible es usar solo las coincidencias exactas y votar entre ellas. Si discrepan, la discrepancia informa de lo que las variables registradas no distinguen; no conviene ocultarla eligiendo la primera fila del historial.
La distancia también se diseña
La distancia euclídea empieza por restar coordenadas del mismo tipo entre dos órdenes. Elevas esas diferencias al cuadrado, las sumas y extraes la raíz cuadrada. Cada coordenada aporta más cuanto mayor es su diferencia numérica. Ahí aparece un problema de negocio: un cambio de unidad que no altera el mundo sí puede cambiar el turno que asignamos.

En la lámina, si usamos directamente metros y minutos, la distancia de A es la raíz de 1² + 8², aproximadamente 8,06; la de B es la raíz de 2² + 1², aproximadamente 2,24. Gana B. Al pasar a centímetros, la primera coordenada de A es 100 y la de B, 200: gana A. Ningún cliente se ha movido. La suma de cuadrados ha cambiado la importancia relativa de las variables.
Una respuesta posible es expresar cada diferencia en desviaciones típicas de su variable. Otra es fijar escalas que tengan sentido para el servicio técnico: «una hora adicional de inactividad importa tanto como este cambio medido de vibración». Ambas son decisiones que se prueban con datos. Las medias y escalas estadísticas se calculan con el histórico de entrenamiento, también dentro de cada partición de validación. Si las calculas incluyendo el mes que pretendes predecir, tu evaluación ya conoce algo de ese mes.
Del voto a estimar minutos
El jefe de taller cambia la pregunta: «¿Cuánto tiempo reservo?». Ahora la respuesta es numérica. Se conserva la idea de comparar precedentes, pero en lugar de contar etiquetas promediamos las duraciones observadas. Si cada duración es y y cada peso es w, la predicción local es la suma de los productos peso por duración dividida entre la suma de los pesos. Dividir garantiza que el resultado vuelva a estar expresado en minutos.
\[\widehat y(x)=\frac{\sum_i w_i(x)y_i}{\sum_i w_i(x)}.\]
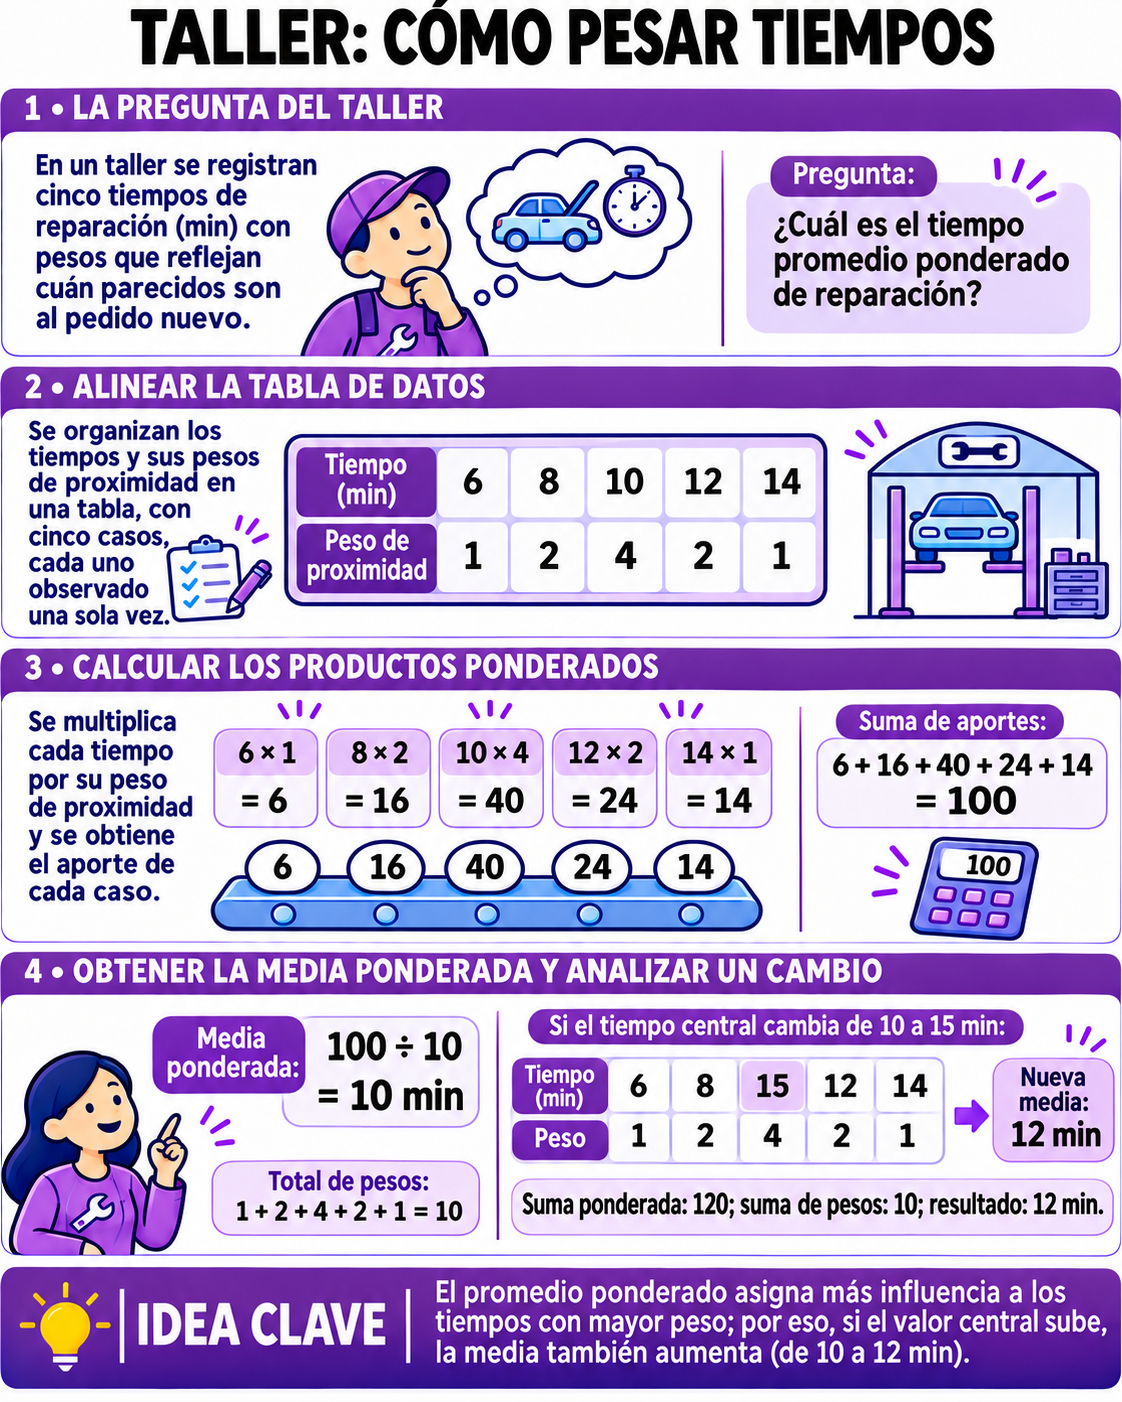
Aquí los pesos disminuyen al alejarnos del centro. Un kernel de suavizado permite calcular pesos con esa forma. El ancho de banda controla la distancia a partir de la cual pierden importancia los precedentes. Estrecharlo deja mandar a los casos más próximos; ensancharlo hace participar a casos más lejanos. En los k vecinos fijamos cuántas observaciones entran y el radio necesario puede crecer en regiones con pocas observaciones. Con un ancho de banda fijo decidimos la escala del vecindario y la cantidad de datos útiles puede variar. En una zona apenas observada, pedirle al sistema un número con dos decimales no fabrica evidencia.
La estimación de densidad con kernels plantea otra pregunta: «¿En qué regiones se concentran las órdenes?». Para estimar una densidad no hacen falta etiquetas de urgencia ni tiempos de reparación. Cada observación deposita una pequeña cantidad de masa a su alrededor y el conjunto se normaliza para que el área total sea uno. Para estimar el tiempo, en cambio, sí necesitamos las duraciones. Para clasificar por urgencia necesitamos etiquetas u otra regla que vincule las densidades con las clases. Que una máquina sea rara no demuestra que esté a punto de fallar. La guía de vecinos de scikit-learn separa las salidas de clasificación y regresión; el estimador de densidad responde a esta tercera pregunta.
Probar la decisión antes de aplicarla
Reserva el último mes de órdenes y usa solo los meses anteriores para comparar k, distancia y ponderación. Si varias filas corresponden a la misma máquina, comprueba si el escenario real permite reconocerla en el futuro. Un reparto aleatorio que deje inspecciones casi idénticas a ambos lados puede hacer que el algoritmo parezca más competente de lo que será al llegar un modelo de máquina nuevo. Compara con una regla sencilla, como asignar siempre la clase más frecuente, y registra por separado cuántas urgencias se pierden y cuántas falsas alarmas se generan. Esa tabla traduce un cambio de k a una conversación que el taller puede tener.
Ejercicio resuelto · cambia un tiempo sin tocar los pesos
En la lámina del promedio local, sustituye solo la duración central de 10 por 15 minutos. El numerador gana 4 × 5 = 20; el denominador sigue en 10. La nueva predicción es 120/10 = 12 minutos. Una modificación de cinco minutos en una fila no equivale a cinco minutos en la predicción.
Transferencia · ¿sirve guardar más variables?
Se propone medir veinte temperaturas que son ruido para esta avería. ¿Las incluirías automáticamente en la distancia? No. Sus diferencias también entrarían en la suma de cuadrados y podrían ocultar las dos características que sí distinguen la urgencia. Compara las dos versiones en pedidos posteriores, manteniendo idéntica la partición. Más información registrada no implica una mejor definición de parecido.
En la orden inicial, dos reglas razonables dieron respuestas opuestas. Ya sabemos explicar por qué y calcular la diferencia. Para decidir cuál conservar falta una medición muy concreta: qué regla reduce los errores que de verdad cuestan un turno o una avería al taller.