ADICTOS A LA IA · MATEMÁTICAS · UNIDAD 1
Dos sensores normales, una lectura conjunta extraña
9 minutos de lectura · Manual, pp. 13–16 · Diapositivas 41–45
Imagina una prueba de arranque de un motor. Llegan dos lecturas. La vibración está una desviación típica por encima de lo habitual. La corriente también. Nada llamativo si miras cada pantalla por separado. Una hora después la vibración vuelve al mismo valor, pero la corriente está una desviación por debajo de su media. Cada pantalla sigue mostrando un dato corriente. ¿Pondrías las dos observaciones en la misma cola de revisión?
Depende de qué pareja sea habitual. Si ambos sensores suelen subir juntos cuando aumenta la carga, el segundo par merece otra mirada. No necesitamos inventar un tercer sensor: necesitamos conservar la relación que se perdió al abrir dos histogramas separados. Ese es el trabajo de la normal multivariada.
Un registro es una pareja, no dos listas
Tomamos las lecturas al mismo instante y las guardamos como un vector columna \(X=(X_1,X_2)^\top\). El primer componente mide vibración y el segundo corriente. Antes de compararlos restamos a cada uno su media de referencia y dividimos por su propia desviación típica, calculadas en un periodo estable. Así, un 1 significa «una desviación por encima de la media de ese sensor». No significa un amperio ni una unidad de vibración. Esta transformación no hace normales los datos; solo cambia su origen y escala.
El vector de medias \(\mu=E[X]\) ubica el centro de la nube. La matriz de covarianzas describe cómo se dispersan las observaciones alrededor de él. Se construye centrando cada par, multiplicando cada desviación por la del otro sensor y promediando:
\[\Sigma_{ij}=E[(X_i-\mu_i)(X_j-\mu_j)].\]Si ambas señales quedan por encima de su media en el mismo instante, ese producto es positivo. También es positivo cuando ambas quedan por debajo. Si tienden a ir en sentidos contrarios, los productos negativos pesan más. Los elementos diagonales son varianzas: al multiplicar una desviación por sí misma se obtiene su cuadrado. Los dos elementos fuera de la diagonal coinciden porque el orden de los dos factores no cambia el producto.
En el ejemplo las varianzas son uno y la correlación es 0,8. Como ya hemos estandarizado los sensores, esa correlación también es la covarianza. Para datos en unidades físicas habría que dividir la covarianza por el producto de las desviaciones típicas antes de llamarla correlación.
\[\mu=\begin{pmatrix}0\\0\end{pmatrix},\qquad \Sigma=\begin{pmatrix}1&0.8\\0.8&1\end{pmatrix}.\]
Qué añade la palabra «normal»
Saber la media y la covarianza no identifica cualquier distribución. Podemos dibujar dos poblaciones separadas con la misma media y covarianza que una nube única. Al adoptar la normal multivariada asumimos algo más fuerte: cualquier combinación lineal de las coordenadas tiene distribución normal, permitiendo el caso degenerado de varianza cero. Eso permite describir la distribución conjunta solo con \(\mu\) y \(\Sigma\). Dos histogramas marginales con forma de campana no demuestran esa hipótesis conjunta.
Cuando la covarianza es definida positiva, existe su inversa y la densidad en un punto \(x\) de dimensión \(d\) es:
\[f(x)=\frac{1}{(2\pi)^{d/2}|\Sigma|^{1/2}}\exp\!\left[-\tfrac12(x-\mu)^\top\Sigma^{-1}(x-\mu)\right].\]Lee la fórmula desde dentro. Primero restamos el centro. Después la inversa de la covarianza pondera una desviación según la variación disponible en su dirección. El producto con el vector transpuesto devuelve un solo número: la distancia cuadrática de Mahalanobis, \(D^2\). El signo menos hace que la densidad disminuya al aumentar esa distancia. El determinante \(|\Sigma|\) ajusta la altura para que la integral de toda la densidad sea uno; una nube más dispersa sufre una reducción de altura. La altura en un punto no es la probabilidad de que ocurra ese punto exacto: para una variable continua esa probabilidad es cero. Si queremos probabilidades, necesitamos regiones de lecturas y un área sobre la que integrar.
La misma distancia al centro produce dos respuestas
Compara \(A=(1,1)\) con \(B=(1,-1)\). La distancia euclídea al origen es \(\sqrt2\) para ambos. También sus histogramas marginales les asignarían la misma plausibilidad: en uno de los sensores solo hemos cambiado el signo. La diferencia está en el producto de las dos coordenadas.
\[D^2(x_1,x_2)=\frac{x_1^2-2\rho x_1x_2+x_2^2}{1-\rho^2}.\]Esta cuenta es el producto matricial anterior para dos coordenadas estandarizadas con correlación \(\rho\). El denominador es el determinante de la covarianza. Con \(\rho=0,8\), vale \(1-0,64=0,36\). Para el punto A el término cruzado resta; para B cambia de signo.
\[D^2(A)=(1-1.6+1)/0.36=1.111\ldots\] \[D^2(B)=(1+1.6+1)/0.36=10.\]Son distancias al cuadrado. Si se pide la distancia, hay que tomar la raíz. Tampoco son porcentajes de avería. Lo que sí podemos comparar, bajo el mismo modelo, son las densidades relativas. El factor que multiplica la exponencial es idéntico; al dividir \(f(B)/f(A)\) queda \(\exp[-(10-1,111\ldots)/2]\), aproximadamente 0,012. Pequeñas regiones de igual área alrededor de B y A tendrán probabilidades en una proporción parecida si son lo suficientemente pequeñas. Esto nos dice por qué mirar B antes, no por qué falló el motor.

Cómo leer los contornos de las diapositivas
Las diapositivas 44–45 usan horas de estudio y nota. Sus medias son 3 y 7; sus desviaciones típicas, 1,5 y 1,2. Con correlación 0,65, la covarianza vale 0,65 × 1,5 × 1,2 = 1,17. La diagonal de la matriz contiene 2,25 y 1,44, las varianzas, no las desviaciones. Una inclinación ascendente describe asociación en ese modelo, no el efecto causal de estudiar una hora más.
Nuestros sensores son un segundo ejemplo, construido con otra escala y otra correlación. Los contornos del gráfico siguiente se calculan fijando la distancia cuadrática. Todos los puntos de cada contorno tienen igual densidad; distintas curvas representan niveles diferentes. Los ejes tienen la misma escala.
Sensor de corriente frente a sensor de vibración
Centro: (0; 0) · Correlación: +0,8 · Ambos sensores tienen varianza 1
En el caso de los sensores, los contornos corresponden a distancias cuadráticas 1, 4 y 6,25. El punto A, (1; 1), sigue la dirección de mayor dispersión. B, (1; −1), tiene el mismo radio euclídeo, pero cae fuera de los tres contornos.
La misma historia, vista desde un solo instrumento
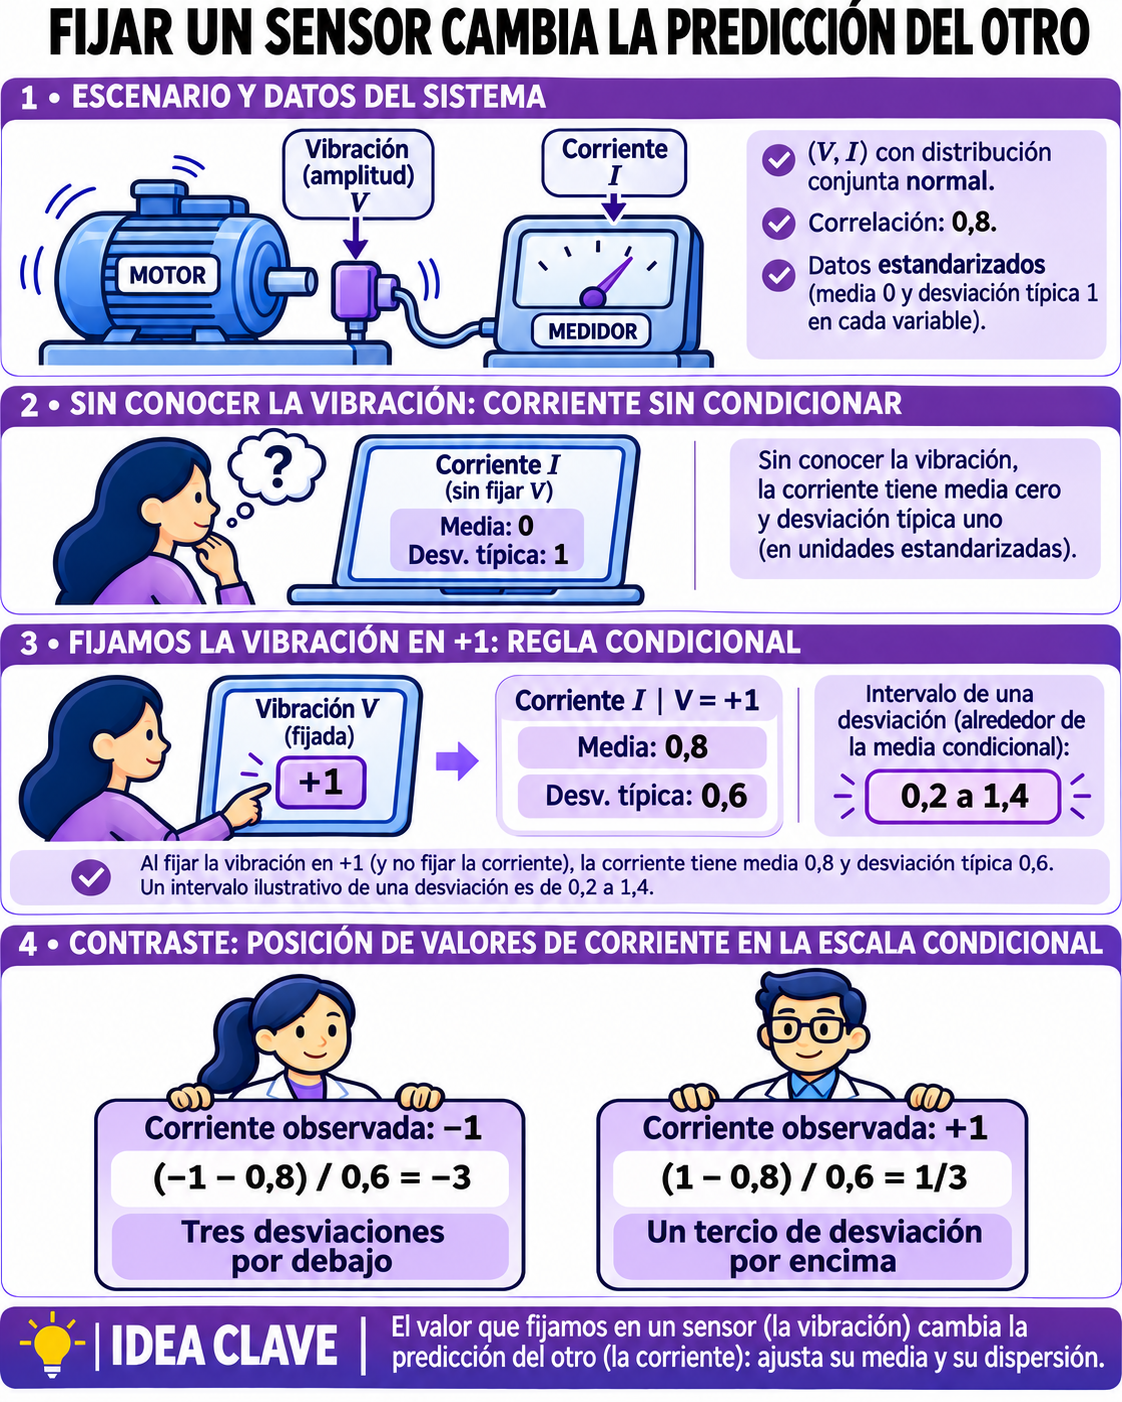
En el sensor de corriente, leído sin más información, la media sigue siendo cero y la varianza uno: esa es su distribución marginal. Ahora fija la vibración en uno. El centro de las lecturas de corriente compatibles con esa vibración se desplaza hacia 0,8; su varianza baja a 0,36. En este ejemplo la condicional es \(X_2\mid X_1=x_1\sim\mathcal N(0{,}8\,x_1;\;0{,}36)\), donde el segundo parámetro es varianza. El ancho típico residual es 0,6, su raíz cuadrada. Con vibración uno, corriente uno queda a un tercio de desviación residual de lo esperado; corriente menos uno queda a tres desviaciones por debajo. El cálculo se refiere a la ley condicional, aunque la observación de un valor exacto tenga probabilidad marginal cero.
Esta interpretación permite comprobar el dibujo. Los contornos de igual densidad son elipses inclinadas hacia la diagonal ascendente. Si cambiamos el signo de la correlación, las marginales no cambian, pero la elipse se inclina hacia la diagonal descendente. Si la correlación llega exactamente a uno, el segundo sensor estandarizado coincide con el primero: todos los puntos están sobre una recta. La covarianza es singular y ya no existe la densidad ordinaria bidimensional escrita arriba. El proceso no desaparece: pierde una dimensión efectiva.
Una elipse depende de quién entró en la muestra
El sensor se evalúa contra un centro y una covarianza que en la fábrica habrá que estimar. Un experimento de simulación en modelización ecológica comparó distintos estimadores de centro y dispersión con muestras de tamaños diferentes, errores de observación y sesgo de muestreo. Un método resistente a valores atípicos puede seguir siendo sensible al sesgo de selección. Traducido a nuestro caso: si calibramos solo con el turno de mañana, la elipse no representa automáticamente la línea de noche. Una puntuación alta pide investigar; no demuestra una avería.
De una tabla de calibración a la matriz
En la ficha técnica aparecen parámetros de la población. En el taller tenemos una muestra. Imagina registrar vibración una vez por segundo y corriente cada diez segundos. Emparejar la primera fila con la primera y así sucesivamente sería un error: estaríamos estimando la relación entre instantes distintos. Primero alinearíamos relojes y elegiríamos una unidad de observación común. Después retiraríamos de cada columna su media de calibración.
La estimación muestral habitual de la covarianza suma los productos de desviaciones emparejadas y divide por n menos uno cuando estimamos la media con esos mismos n registros. Otros ajustes por máxima verosimilitud emplean n como denominador. Conviene decir cuál usamos; dos programas pueden dar cifras ligeramente distintas sin contradecirse. Con miles de muestras la diferencia de divisor será pequeña; con tres lecturas es fácil verla. Ninguna elección de divisor corrige un sensor desincronizado.
Finalmente reservaríamos un tramo estable no usado al construir la elipse. Si muchas lecturas de ese tramo parecen excepcionales, comprobaríamos primero si ha cambiado la carga, la calibración o la distribución. Una frontera muy precisa alrededor de la población equivocada sigue siendo una mala alarma.
Ensayo resuelto y pregunta de transferencia
Supón que instalamos el segundo sensor con el signo invertido sin modificar las etiquetas del histórico. La correlación real de las señales nuevas pasa a −0,8. Para A la distancia cuadrática es ahora 10, para B es 1,11. La regla matemática funciona; la referencia vieja haría saltar alarmas por un cambio en la instrumentación. Antes de llamar a mantenimiento comprobaríamos fecha de instalación, calibración y sincronía entre ambos canales.
¿Qué cambia si la correlación vale cero?
En el modelo normal conjunto, \(\Sigma=I\), así que \(D^2=x_1^2+x_2^2\). A y B obtienen 2. Para esta familia, covarianza cero implica independencia de ambas coordenadas. Fuera de la familia no es una regla general: si \(X\) tiene una distribución simétrica centrada y \(Y=X^2\), la covarianza puede ser cero aunque conocer \(X\) determine por completo \(Y\).
Para reconstruir la decisión, basta con anotar tres cosas junto a una alerta: qué referencia fijó el centro, qué relaciones quedaron en la covarianza y qué combinación concreta se apartó de esa referencia. El equipo puede comprobar cada una antes de decidir si la incidencia es mecánica, eléctrica o de medición.
Abrir expediente: fuentes, pasajes consultados y límites