ADICTOS A LA IA · MATEMÁTICAS · UNIDAD 1
¿Qué dirección conserva los datos y cuál separa las clases?
9 minutos de lectura · Manual, pp. 18–20 · Diapositivas 49–54
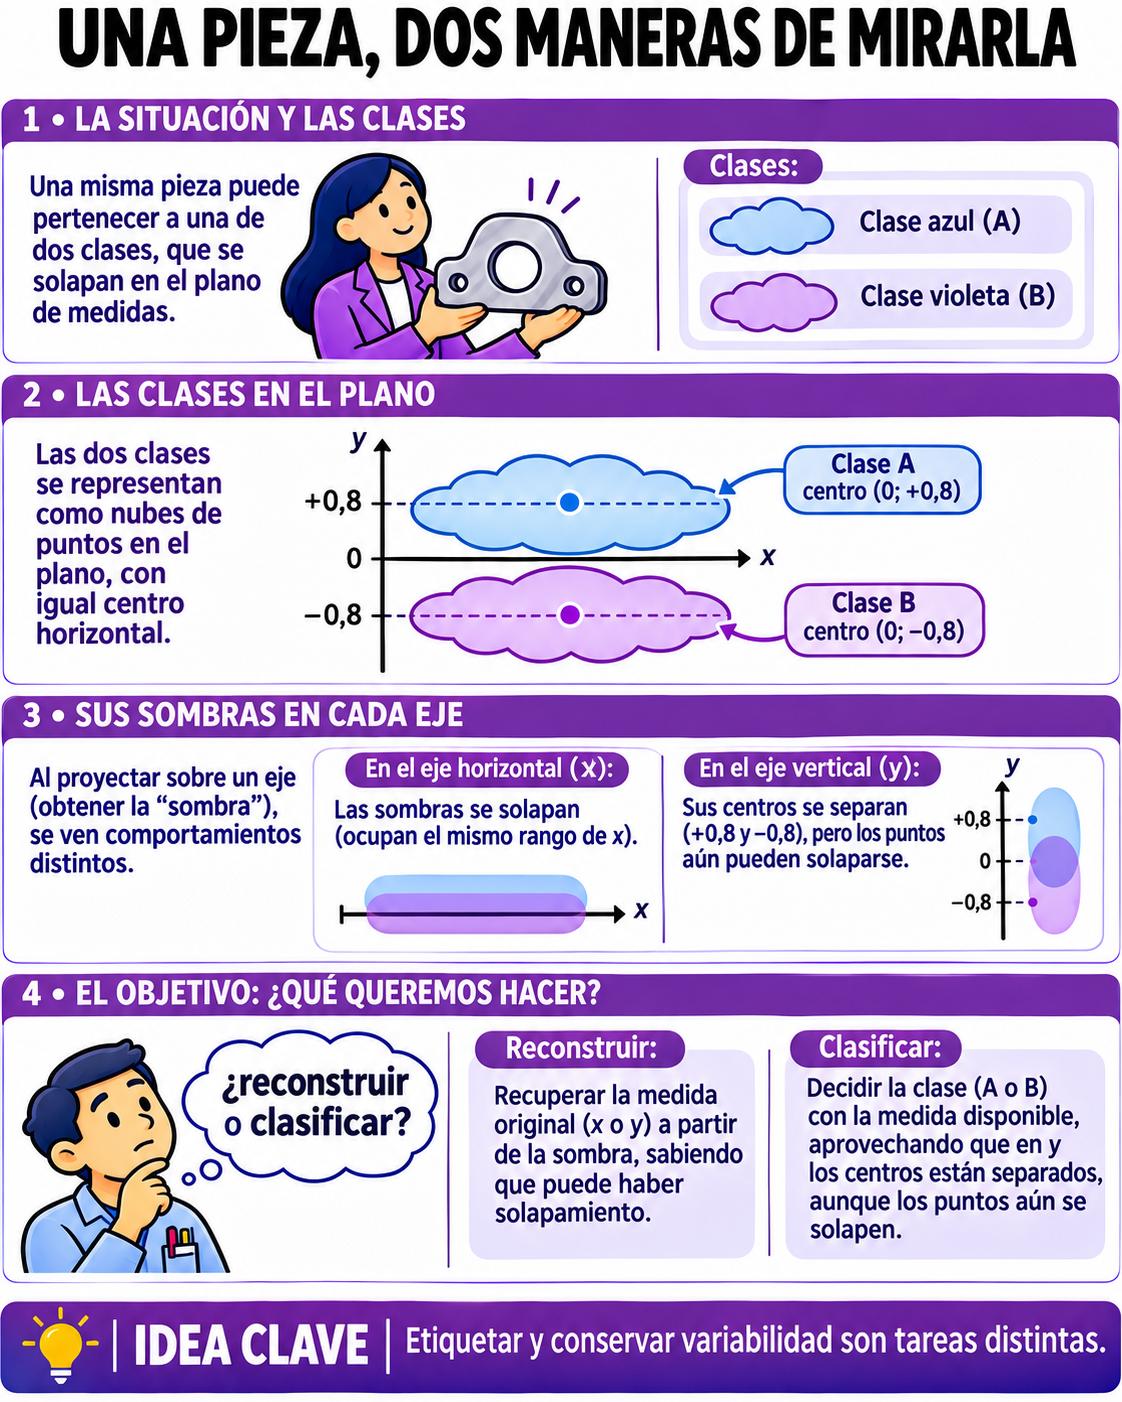
Una máquina produce dos medidas por pieza y la memoria disponible solo admite una. Podemos guardar la primera, la segunda o una combinación de ambas. La responsable de mantenimiento quiere reconstruir las lecturas originales con la menor pérdida. La responsable de calidad quiere distinguir piezas de dos clases ya conocidas. ¿Tienen que guardar el mismo número?
Vamos a construir un conjunto de datos para el que ambas toman decisiones diferentes y ambas tienen razón. El truco no es escoger el algoritmo más avanzado: es escribir qué resultado perderíamos si escogiéramos la dirección equivocada.
Una dirección y la sombra de cada punto
Cada observación es una pareja \(x=(x_1,x_2)^\top\). Centramos las columnas restando a cada una su media de entrenamiento. Fijamos una flecha unitaria \(u=(u_1,u_2)^\top\). Su longitud es uno; su orientación es lo que vamos a elegir. Al guardar el producto escalar obtenemos un número por observación:
\[z=u^\top(x-\bar x)=u_1(x_1-\bar x_1)+u_2(x_2-\bar x_2).\]Si la flecha es horizontal, \(u=(1,0)\), el archivo conserva únicamente la primera coordenada centrada. Si es vertical, conserva la segunda. Si apuntara a 45 grados, combinaría ambas. La escala unitaria evita ganar artificialmente multiplicando por diez la flecha: eso no descubriría información, solo escribiría números mayores.
Es una transformación lineal de los datos ya centrados. Si \(Y=AX\), entonces su media es \(A\mu\) y su covarianza es \(A\Sigma A^\top\). Para una sola proyección, \(A\) tiene una fila y esa última expresión se convierte en un escalar: la varianza de lo guardado, \(u^\top\Sigma u\).
Una fábrica con dos direcciones de interés
Trabajaremos en unidades previamente acordadas por el equipo. En este ejemplo el primer sensor tiene varianza 9, el segundo 1 y la covarianza entre ambos es cero. No hemos estandarizado por separado cada columna, porque hacerlo cambiaría el problema. La matriz de covarianza total es diagonal:
\[\Sigma=\begin{pmatrix}9&0\\0&1\end{pmatrix}.\]Imagina dos nubes alargadas en horizontal, una centrada un poco más arriba que la otra. Las clases tienen el mismo tamaño y sus centros son \((0;\,-0{,}8)\) y \((0;\,+0{,}8)\); aquí la coma decimal indica ocho décimas en la coordenada vertical. Dentro de cada clase, la varianza del segundo sensor es 0,36. Comprueba que el ejemplo es coherente: el promedio de las varianzas internas es 0,36 y la varianza de los dos centros verticales es 0,64; al sumar resultan exactamente la varianza vertical total 1. En horizontal las dos clases tienen la misma media y la misma dispersión interna, 9.
PCA quiere retener variación
La primera componente principal es la dirección unitaria en la que las proyecciones de todos los puntos tienen mayor varianza. Ignora las etiquetas incluso si están en la hoja: no necesita saber de qué clase era cada pieza. El problema matemático es:
\[\max_{\lVert u\rVert=1} u^\top\Sigma u.\]En nuestro caso la expresión vale \(9u_1^2+u_2^2\). Como \(u_1^2+u_2^2=1\), podemos reescribirla como \(1+8u_1^2\). Para que sea máxima necesitamos \(u_1^2=1\), así que escogemos el eje horizontal. Su signo es indiferente: si el programa devuelve la flecha contraria las puntuaciones cambian de signo, pero representan la misma recta. La varianza conservada es 9 de un total de 10. De ahí sale ese 90 % que veríamos en un informe de componentes principales.
La regla general es tomar un autovector de la covarianza asociado al autovalor mayor. Para entenderlo físicamente, imagina rotar el eje y buscar la sombra más alargada de toda la nube. El autovalor expresa la varianza sobre la dirección elegida. Si conservamos varias componentes sucesivas, elegimos direcciones ortogonales que recogen la siguiente mayor varianza. Cuando dos autovalores coinciden, puede haber más de una base igualmente válida para ese subespacio.
Con este criterio, proyectar sobre una dirección y reconstruir el punto mediante \(\hat x=\bar x+uz\) minimiza la pérdida cuadrática total entre proyecciones lineales ortogonales de rango uno. No reconstruye cada punto exactamente. Para \(x=(3;\,0{,}8)\), en notación verbal «tres en horizontal y ocho décimas en vertical», la reconstrucción horizontal conserva el tres y devuelve la media vertical, cero. En esta pieza concreta perdemos precisamente la señal que interesaba a calidad, aunque el error agregado de reconstrucción sea el menor disponible.

El ejemplo de clase emplea columnas estandarizadas
Las diapositivas 51–52 empiezan con cuatro observaciones: (2; 1), (3; 2), (4; 3) y (5; 4). La segunda columna siempre vale la primera menos uno. Después de centrar y dividir cada columna por su desviación, son idénticas. Su matriz de correlaciones tiene unos en las cuatro casillas y los autovalores son 2 y 0. Una componente basta para conservar toda la varianza de esos cuatro registros: 2 dividido por (2 + 0) da el 100 %.
Nuestro ejemplo industrial resuelve una pregunta distinta: conservar varianza en las unidades escogidas para las piezas. Si estandarizáramos por separado las dos columnas de este ejemplo de sensores no correlacionados, la matriz pasaría a ser la identidad. Las dos direcciones tendrían varianza uno y PCA no podría preferir horizontal frente a vertical. El 90 % anterior pertenece al cálculo sobre covarianzas sin ese reescalado, no al ejemplo del profesor.
LDA quiere conservar la separación
Ahora destapamos las etiquetas. Para juzgar una dirección miramos dos cantidades: cuánto se alejan las medias proyectadas de las clases y cuánto varían entre sí los puntos que pertenecen a la misma clase. Una diferencia de medias de dos unidades significa poco si la dispersión interna es enorme y mucho si los dos grupos son compactos. El criterio de Fisher pone una medida en el numerador y la otra en el denominador:
\[J(u)=\frac{u^\top S_Bu}{u^\top S_Wu}.\]Los subíndices corresponden a las palabras inglesas between y within. \(S_B\) mide la dispersión entre centros de clase; \(S_W\), la dispersión dentro de las clases. Podemos normalizar ambos por el tamaño total para interpretarlos en unidades de covarianza. Con esa convención, en nuestro ejemplo las diagonales de \(S_B\) son 0 y 0,64 y las de \(S_W\) son 9 y 0,36. Los elementos cruzados también son cero.
En horizontal el criterio da \(0/9=0\): la separación entre clases desaparece en las medias proyectadas. En vertical da \(0,64/0,36\approx1,78\). Si añadimos algo de horizontal a esta dirección solo añadimos dispersión interna sin aumentar la separación. Gana el eje vertical. Las dos nubes aún pueden solaparse: LDA busca mejorar separación relativa, no promete clasificar sin errores. Para proyectar las observaciones posteriores usaremos la dirección aprendida en entrenamiento; para aprenderla sí eran necesarias las etiquetas.
Con más variables y clases, las direcciones candidatas se obtienen resolviendo \(S_Bu=\lambda S_Wu\) cuando el problema está bien condicionado. Con dos clases hay como máximo una dirección discriminante no trivial. Si hay muy pocas piezas frente al número de sensores, \(S_W\) puede ser singular: no conviene tratar su inversión como una operación inocua.
Para visualizar la separación, supongamos además que cada clase es normal con varianzas internas 9 y 0,36 y covarianza interna cero. Es una hipótesis ilustrativa del dibujo; el criterio de Fisher que acabamos de calcular solo necesita las dispersiones y las etiquetas.
Las dos clases se extienden en horizontal y se desplazan en vertical
━━ Centro superior: (0; +0,8) ━━ Centro inferior: (0; −0,8)
Las líneas continuas y discontinuas son los contornos de una y dos unidades de distancia de Mahalanobis dentro de cada clase. Los dos centros comparten coordenada horizontal. El solapamiento impide leer el dibujo como una clasificación perfecta.

Prueba de unidades: ¿qué le hemos pedido al modelo?
Cambiar de metros a centímetros no añade información al sensor. Pero al multiplicar por 100 una columna, su varianza se multiplica por 10 000. El PCA sobre covarianzas sí nota esa decisión, porque ahora los errores de reconstrucción en esa columna tienen otro peso numérico. Estandarizar las columnas equivale a contestar otra pregunta: cuánta variación relativa conservamos respecto a la dispersión habitual de cada sensor. No es una receta automática. Si ambos sensores midieran la misma propiedad en la misma unidad física, eliminar sus diferencias de escala podría borrar una diferencia relevante para mantenimiento.
Otra decisión puede echar por tierra toda la comprobación. Si primero estimamos medias, escalas o direcciones con la colección completa y después separamos los datos de prueba, parte de la información de prueba entra en el entrenamiento. Esto ocurre incluso en PCA, aunque no lea etiquetas. Para valorar una línea nueva, separamos primero las piezas; ajustamos el centrado y la proyección únicamente en las de entrenamiento y aplicamos esa transformación ya fijada a las demás.
La pregunta cambia la dirección: el caso de las peras
Una cámara hiperespectral guarda muchas bandas por fruta. Si interesa comprimir imágenes, conservar variación puede ser razonable. Si interesa separar tejido magullado de tejido sano, quizá la dirección de mayor variación esté dominada por iluminación. En un estudio de inspección de peras Yali se compararon proyecciones como PCA y una variante regularizada de LDA manteniendo el mismo clasificador posterior. La variante supervisada obtuvo mejor separación en ese experimento; la validación incluyó 300 frutos independientes. Ese resultado no demuestra que LDA gane siempre ni que estimemos aquí sus porcentajes: muestra por qué hay que validar con el objetivo de la aplicación y con frutas nuevas, no con píxeles hermanos de las que ya vimos.
Ejercicio: defender una proyección delante de los dos equipos
Si la tarjeta permite dos bytes para resumir una lectura y el criterio es error cuadrático en las unidades actuales, guardaríamos la proyección horizontal: perdemos una unidad de varianza sobre diez. Si la tarjeta alimenta un control cuyo objetivo es distinguir las dos clases descritas, ensayaríamos primero la vertical y mediríamos su desempeño en piezas nuevas con etiquetas fiables. Solo entonces fijaríamos el umbral concreto. El «90 %» de PCA no significa «90 % de aciertos»: se refiere a otra magnitud y tiene otro denominador.
Si duplicamos el primer sensor, ¿qué porcentaje anuncia PCA?
La nueva varianza es \(2^2\times9=36\); la otra sigue siendo 1. La fracción sube a \(36/37\approx97,3\%\). No hemos separado mejor las clases: los centros siguen teniendo la misma coordenada horizontal. Si no recordamos qué se mantuvo fijo, podríamos celebrar una mejora que solo vino de cambiar una unidad.
La pregunta inicial ya tiene dos respuestas concretas: guardar horizontal para reconstruir el conjunto, guardar vertical para distinguir las clases del ejemplo. Cuando alguien enseñe un porcentaje de varianza explicada, pregunta qué decisión espera tomar después y si ese porcentaje mide realmente su éxito.
Abrir expediente: fuentes, pasajes consultados y límites