¿Qué máquina llenó este paquete si nadie guardó su etiqueta?
Algoritmo EM y agrupamiento probabilístico
Origen del concepto y de los datos
Material docente. Manual §§5.1–5.2, pp. 24–27; diapositivas 63–66. La unidad enseña variables latentes, esperanza condicional de la log-verosimilitud completa, maximización y pertenencia probabilística en una mezcla.
Ejemplo hipotético de esta bitácora. Las dos envasadoras son una escena propia. La normalización 0,03/0,04 y la tabla de paquetes de 10 y 14 g son dos ejercicios ilustrativos. La gráfica reconstruye la segunda tabla con parámetros explícitos; no pretende que 0,03 y 0,01 sean densidades evaluadas en esa gráfica.
Imagina dos máquinas que envasan el mismo producto. En este escenario hipotético solo conservamos los pesos; no registramos qué máquina llenó cada paquete. El jefe de planta no pregunta solo si el peso medio global cambió: quiere averiguar si hay dos comportamientos distintos. Si supiéramos el origen, bastaría reunir los paquetes de cada máquina y calcular sus medias. Si conociéramos bien las dos distribuciones de pesos, sería sencillo estimar el origen probable de cada paquete. Nos falta precisamente una mitad para calcular la otra.
Observamos pesos, no etiquetas
Lectura de contraste ↗Llamamos xᵢ al peso del paquete i y zᵢ a su origen oculto. Suponemos que una fracción π de los paquetes viene de A y el resto de B. Cada componente tiene una densidad f que indica dónde tienden a concentrarse sus pesos. Si ambas son normales, cada una tiene una media y una varianza. La densidad global es una suma ponderada, no la densidad de una sola normal cuyo centro sea una media de los centros.
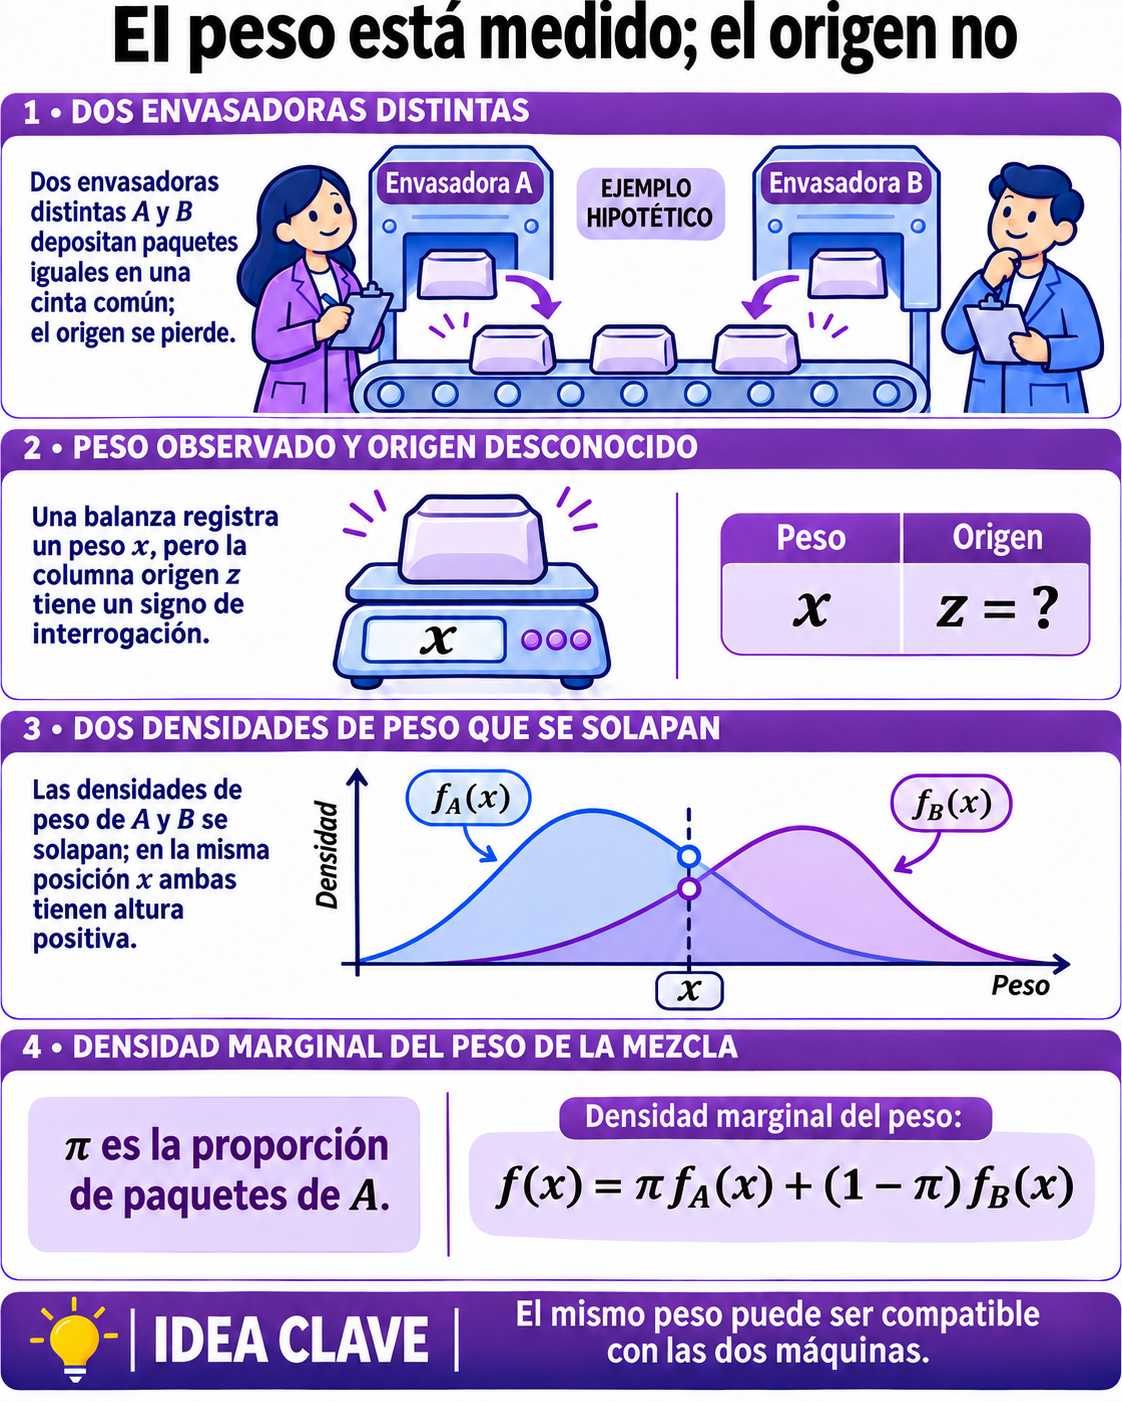
En cada fila debemos sumar antes de tomar el logaritmo, porque el peso observado podría proceder de cualquiera de los dos orígenes. Para datos independientes, la log-verosimilitud que queremos aumentar se obtiene sumando a continuación los logaritmos de esas densidades de mezcla. No podemos separar sin más el logaritmo de una suma como si fuera la suma de dos logaritmos. Esa es la dificultad que trata el algoritmo de esperanza y maximización, o EM.
E de esperanza: repartir la responsabilidad
Lectura de contraste ↗Empezamos con una conjetura de pesos de mezcla, centros y varianzas. Para el primer paquete, supón que al multiplicar el peso de cada componente por su densidad obtenemos 0,03 para A y 0,01 para B. Son contribuciones a una densidad, no probabilidades de acertar la máquina. Para convertirlas en probabilidades de pertenencia condicionales al peso medido, dividimos cada contribución por su suma.
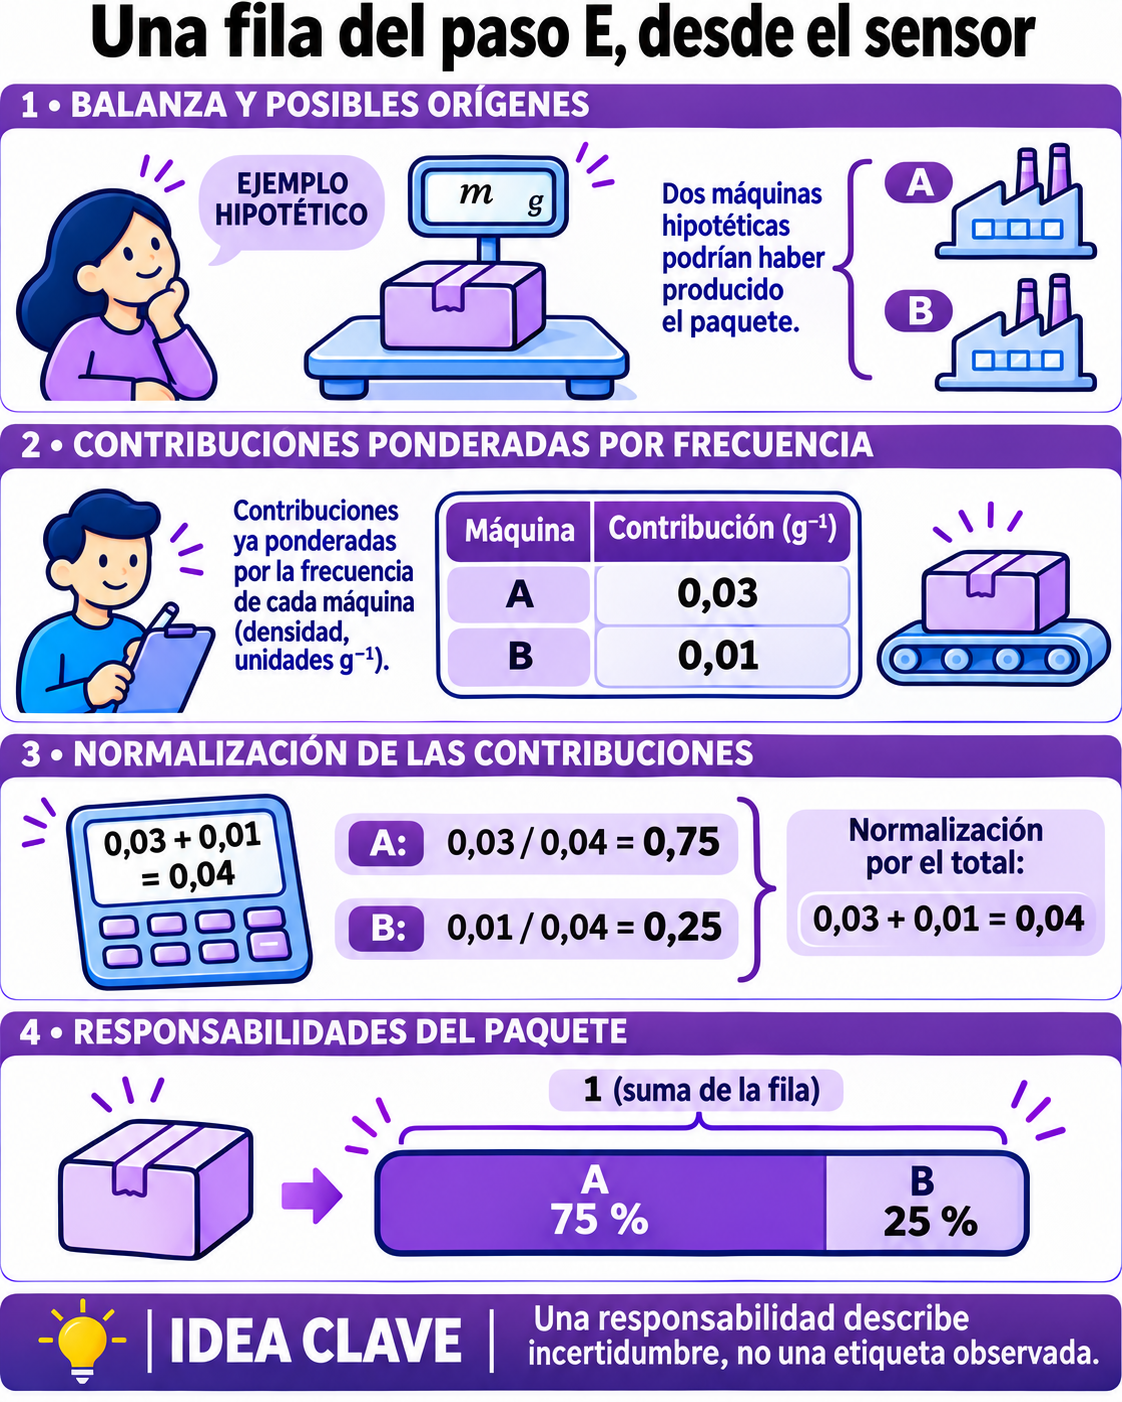
La responsabilidad de B es el 25 % restante. Un responsable podría etiquetar al paquete como A para archivarlo. El algoritmo conserva 0,75 y 0,25, porque forzar un ganador descartaría incertidumbre útil para actualizar el modelo. El 75 % depende de los parámetros actuales y de que el modelo sea razonable: no es una certificación del fabricante ni una etiqueta medida por el sensor.
La E tiene un significado general. Con los parámetros anteriores θᵗ calculamos la esperanza de la log-verosimilitud de los datos completos (x,z), condicionada a los datos observados. En una mezcla, esa esperanza equivale a sumar los términos que tendríamos si conociéramos las etiquetas, ponderados por sus probabilidades actuales. La función auxiliar se suele llamar Q.
M de maximización: calcular con pesos fraccionarios
Lectura de contraste ↗Supongamos, para poder hacer una vuelta a mano, que hay únicamente dos paquetes de 10 y 14 gramos, con responsabilidades para A de 0,75 y 0,25. El primer dato pesa tres veces más que el segundo en el cálculo del centro de A. Su número efectivo de observaciones es 0,75+0,25=1. No hemos contado un paquete entero y descartado el otro: hemos repartido dos contribuciones.
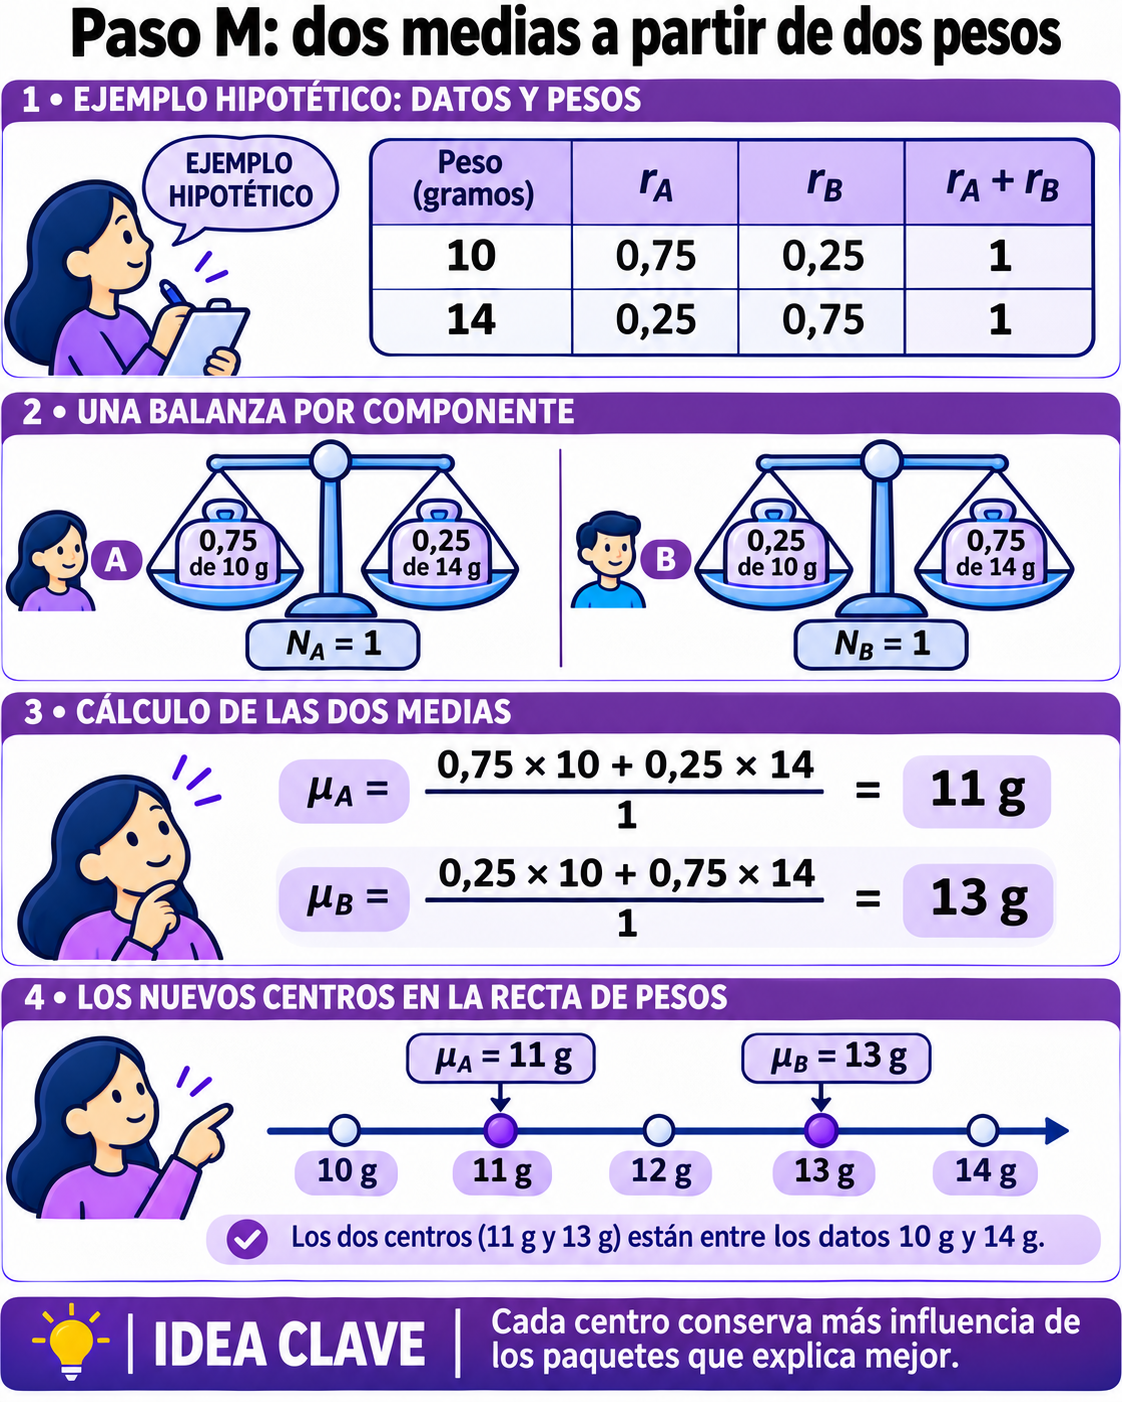
Para B los pesos son 0,25 y 0,75; su media nueva vale 13 gramos. Los dos tamaños efectivos valen uno y suman el número original de paquetes. El nuevo peso de A en la mezcla es N_A/n = 1/2. La varianza actualizada de A promedia las distancias cuadradas a su nuevo centro: 0,75×(10−11)² + 0,25×(14−11)² = 3 g². La de B también resulta 3 g² en este ejemplo simétrico. Ya tenemos ingredientes nuevos para repetir la fase E.
Una vuelta de EM, sin cambiar los paquetes
Sigue los tres pasos en orden. Las líneas de color muestran cuánto aporta cada componente a la densidad total; la línea oscura suma ambas contribuciones. Los dos pesos observados siguen siendo 10 y 14 gramos.
Consultar los valores en tabla
| Estado | Centro A | Centro B | Varianza común |
|---|---|---|---|
| Inicial | 10 g | 14 g | 8/log(3) g² |
| Después de M | 11 g | 13 g | 3 g² |
Qué garantiza realmente una vuelta
Lectura de contraste ↗Si la E calcula la esperanza correcta y la M maximiza Q, la log-verosimilitud observada no disminuye. Puede quedarse igual. No se deduce que cada iteración acierte mejor las etiquetas reales, que aquí ni siquiera conocemos, ni que el punto al que llega sea el mejor de todos. La inicialización importa. De hecho, si arrancamos con dos componentes idénticos y pesos iguales, todos los paquetes reparten su responsabilidad a medias. La actualización mantiene los centros iguales: no se descubre una diferencia solo por insistir.
Además, en una mezcla normal sin restricciones, una componente puede pegar su media a una observación y encoger su varianza casi a cero. La densidad en ese punto puede dispararse. Una solución así no respalda el hallazgo de una nueva máquina. Conviene comprobar varianzas mínimas permitidas, tamaños efectivos, distintos arranques y la estabilidad del resultado en otros datos. Una tolerancia numérica para parar es un criterio práctico, no evidencia de que el sistema físico tenga exactamente dos máquinas.
Qué responder al responsable
Se puede entregar una distribución de orígenes plausibles bajo el modelo y señalar qué paquetes tienen adscripción ambigua. Cuando ambas responsabilidades están cerca de la mitad, derivar una orden de mantenimiento a una máquina concreta sería atrevido. Usaría la información para priorizar el próximo registro en planta: guardar el identificador de origen en una muestra permitiría contrastar la interpretación del agrupamiento.
Has repetido el ajuste y ahora A tiene media 13 y B media 11. ¿Ha empeorado?
Contrasta tu respuesta
Si los pesos, medias y varianzas simplemente han intercambiado sus nombres, la densidad de mezcla es idéntica punto a punto. Por sí solo el cambio no supone una diferencia de ajuste. Para ligar los componentes a máquinas reales hace falta una referencia externa; para comparar varias corridas, empareja los componentes por alguna característica interpretable. Más grupos y mayor verosimilitud de entrenamiento tampoco prueban que en planta haya más máquinas: esa es la pregunta de la siguiente entrada.
Una iteración completa y dos comprobaciones
Una manera de saber si has entendido EM es intentar intercambiar las dos letras. ¿Podrías actualizar las medias antes de calcular las responsabilidades? Haría falta elegir qué parte de cada paquete cuenta para cada centro, y esa parte es precisamente lo que falta. ¿Podrías calcular las responsabilidades sin valores iniciales para las medias y las varianzas? Tampoco: las densidades que comparas dependen de esos parámetros. Por eso es necesario inicializar y alternar. Las dos letras no son los nombres de dos algoritmos rivales.
En la pequeña tabla con dos paquetes, las responsabilidades forman dos filas. La primera contiene 0,75 y 0,25; la segunda 0,25 y 0,75. Cada fila debe sumar uno porque divide una observación entera entre alternativas exhaustivas. Las columnas, en cambio, no tienen por qué sumar uno en general. Su suma es el tamaño efectivo de cada componente. Que aquí cada columna sume uno es una casualidad de la tabla simétrica. Si tu programa normaliza siempre las columnas al actualizar la E, puede dar resultados que parecen ordenados y son conceptualmente incorrectos.
Recuerda que, para estimar la varianza de A, restamos once a ambos pesos, no la media global de doce ni la media antigua. El primer residuo es menos un gramo y el segundo, tres gramos. Sus cuadrados son uno y nueve. Al ponderarlos por tres cuartos y un cuarto resulta tres gramos cuadrados. Si por error devolvieras tres gramos, habrías confundido varianza y desviación típica; la desviación es la raíz de tres gramos cuadrados, aproximadamente 1,73 gramos. Las unidades son una comprobación barata del algoritmo.
Haz una comprobación aparte sobre el papel: fija en cero la responsabilidad para A del primer paquete y conserva en un cuarto la del segundo. Entonces solo contribuye el peso de catorce gramos, con responsabilidad un cuarto. El cociente es catorce aunque el peso ponderado del numerador sea tres y medio. Omitir la división por el tamaño efectivo mostraría tres y medio, fuera del intervalo que va de diez a catorce. Una media ponderada con pesos no negativos debe quedar entre el menor y el mayor valor que contribuyen; ese es un segundo control útil.
Antes de tomar decisiones sobre maquinaria, compararía resultados de varios arranques y observaría los pesos de mezcla, la dispersión de cada componente y los paquetes ambiguos. Si el mismo componente parece corresponder a empaques húmedos por la mañana y secos por la tarde, quizá no hayamos recuperado dos máquinas sino dos condiciones de producción. La etiqueta latente es una cantidad matemática; el significado físico requiere contraste independiente.
Comprueba los números
Pega el bloque en un archivo llamado prueba.py y ejecuta python3 prueba.py en su carpeta. También puedes pegarlo entero en una celda de un cuaderno Python.
x = [10, 14]
for r in ([0.75,0.25], [0.25,0.75]):
    n = sum(r)
    mu = sum(w*v for w,v in zip(r,x))/n
    var = sum(w*(v-mu)**2 for w,v in zip(r,x))/n
    print("peso:", n/len(x), "media:", mu, "varianza:", var)
Salida comprobada
peso: 0.5 media: 11.0 varianza: 3.0
peso: 0.5 media: 13.0 varianza: 3.0
Haz una variación
Cambia las responsabilidades de ambas máquinas a [0.5, 0.5]. Las dos convergen en esta vuelta a una media de 12 gramos y una varianza de 4 g². Es el ejemplo de por qué una inicialización simétrica no separa automáticamente los grupos.
Salida de la variación comprobada
peso: 0.5 media: 12.0 varianza: 4.0
peso: 0.5 media: 12.0 varianza: 4.0
Para contrastar
scikit-learn · Gaussian mixture models. Describe el ajuste de mezclas con EM y la degeneración de covarianzas; se usa para contrastar el diagnóstico, no como garantía global.
scikit-learn · GaussianMixture, Parameters y Attributes. La documentación distingue tolerancia, número de inicializaciones, pesos, medias y covarianzas; también documenta reg_covar. Ver convergencia en la API no demuestra correspondencia física.
Expediente de lectura: obras consultadas y alcance.
Glosario
- Latente
- Parte del modelo no medida directamente; aquí, el origen de cada paquete.
- Responsabilidad
- Probabilidad condicional de pertenencia bajo los parámetros actuales.
- Tamaño efectivo
- Suma de responsabilidades asignadas a un componente.
Procedencia y revisión editorial
Idioma: español. Edición local: 4 de noviembre de 2026. Programa: material de estudio de la unidad 1 y diapositivas de clase de UTAMED. Las cifras de la bitácora son ejemplos didácticos construidos. La procedencia académica y el alcance de cada lectura se detallan en el expediente de fuentes.
Redacción y revisión: Codex, modelo fijado por el cliente; Python para reproducir los cálculos. Infografías y retrato interpretativo: ImageGen. La portada del libro es la imagen editorial de la web de los autores. Para las locuciones se utiliza VoiceStudio local con el perfil autorizado de Iván. Los reproductores se habilitan cuando existe un audio verificado.