Una probabilidad de retraso del 33 %, ¿justifica avisar?
Regresión logística
Origen del concepto y de los datos
Material docente. Manual §4.3, pp. 22–24; diapositiva 62. La unidad introduce la sigmoide, los coeficientes, la estimación por verosimilitud y el uso de umbrales en clasificación binaria.
Ejemplo hipotético de esta bitácora. Las dos tablas de envíos y los costes de aviso son supuestos propios. Los riesgos 20 % y 33,3 % se calculan con esas frecuencias; no se atribuyen al manual ni a una empresa.
Operaciones quiere avisar a los clientes antes de que sus paquetes lleguen tarde. A la hora de decidir, cada envío tiene un resultado futuro que solo podrá ser uno de dos: se retrasa o llega a tiempo. Pero eso no obliga a que la predicción solo pueda valer cero o uno. Saber que un envío tiene más riesgo que otro ayuda a decidir dónde actuar, incluso si ninguno está condenado al retraso.
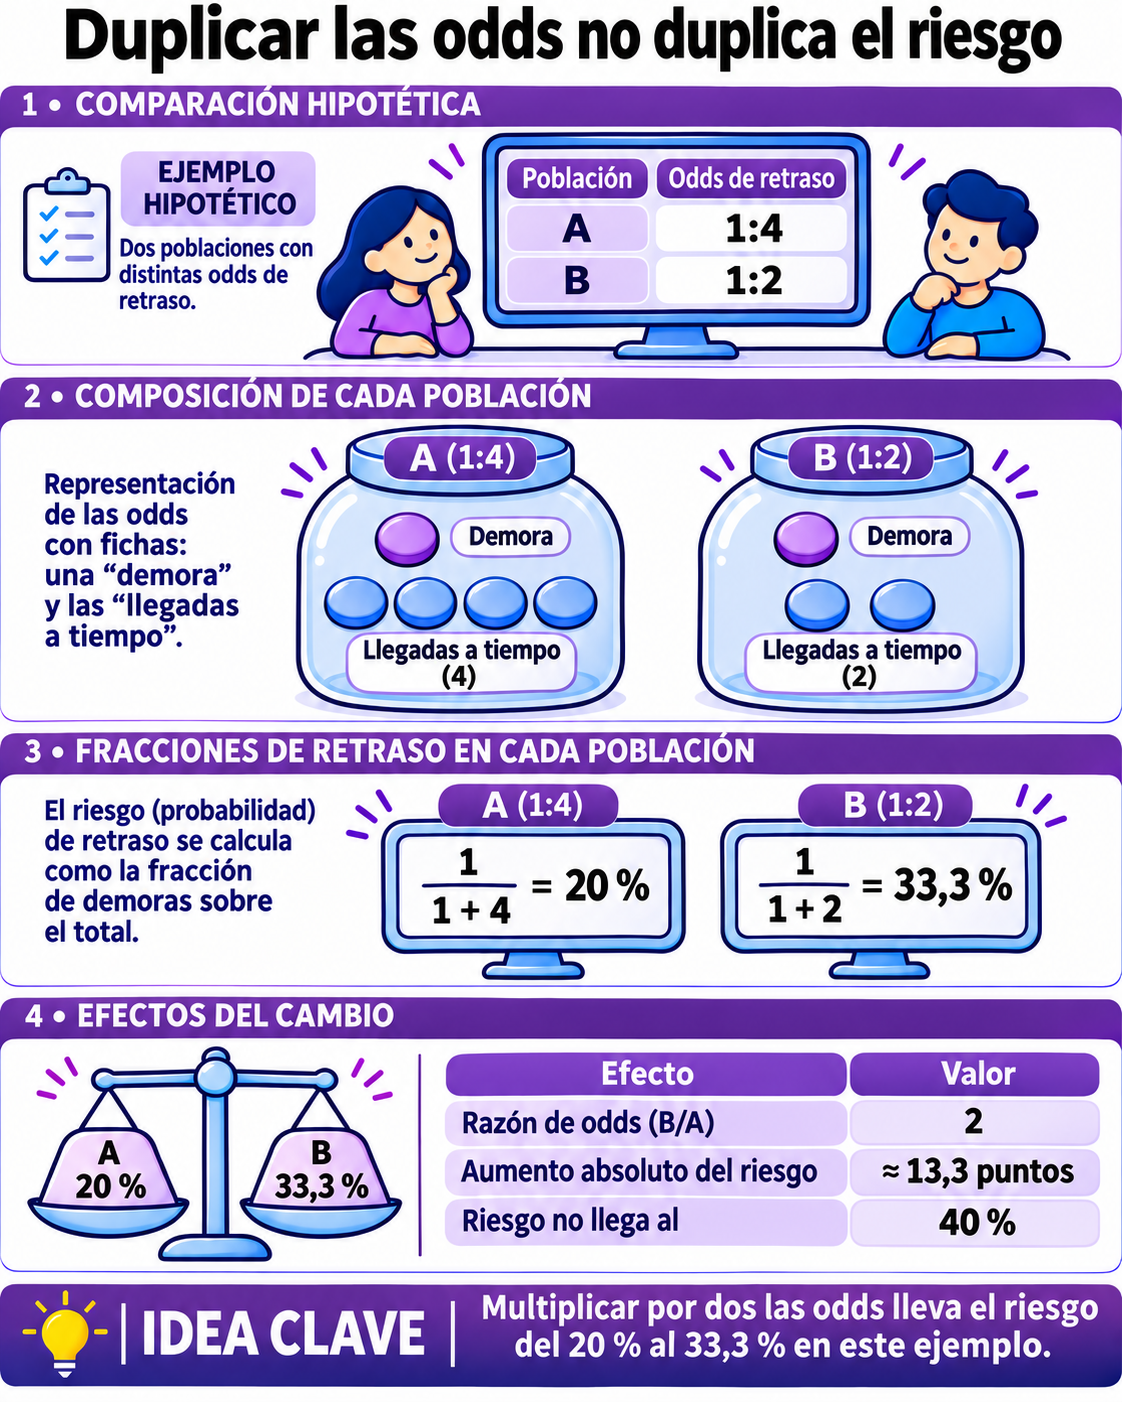
Trabajaremos con una situación inventada en la que podemos reconstruir toda la cuenta. Entre cien envíos comparables que salieron con puntualidad, veinte llegaron tarde. De noventa envíos que salieron tarde, treinta llegaron con retraso. Así podemos calcular el segundo riesgo del ejemplo como treinta entre noventa: un tercio exacto en esta tabla hipotética, no una garantía sobre población alguna.
Qué mide el dato y qué mide el modelo
Lectura de contraste ↗Llamamos y=1 al retraso e y=0 a la llegada en hora. x vale cero si la salida fue puntual y uno si salió tarde. Lo que interesa predecir es p(x), la probabilidad condicional de retraso, no el número final de horas de demora. Un modelo lineal directo de probabilidad podría arrojar −0,1 o 1,2 al prolongarlo. La función logística usa un paso intermedio: modela una cantidad que sí puede crecer en toda la recta real.
Primero distinguimos probabilidad de odds o razón de probabilidades. De los cien envíos iniciales que salieron en hora, veinte acabaron tarde y ochenta llegaron en hora. La probabilidad compara los veinte con cien; las odds comparan los veinte con los ochenta. Las dos expresan la misma evidencia con denominadores distintos.

De una recta a una probabilidad
Lectura de contraste ↗El modelo supone que el logaritmo natural de las odds, llamado logit, es lineal en los predictores. Al exponenciar recuperamos las odds. Al dividirlas por uno más ellas recuperamos una probabilidad entre cero y uno. El vector de coeficientes se ajusta al registro histórico: no hay que decidir a mano qué probabilidad asignar a cada paquete real.
Para representar los dos riesgos del ejemplo elegimos β₀ = log(1/4) ≈ −1,386 y β₁ = log 2 ≈ 0,693. Cuando x=0, las odds valen 1/4 y la probabilidad es 1/5. Cuando x=1, las odds se multiplican por dos y pasan a 1/2; la probabilidad es 1/3. La diferencia entre probabilidades es aproximadamente trece puntos porcentuales. Decir que la probabilidad se duplica confundiría dos escalas.
Dos envíos sobre la misma sigmoide
La recta de predicción produce primero un índice η; la sigmoide lo convierte en probabilidad. Selecciona la salida puntual y después la tardía. Solo esos dos puntos corresponden a los grupos del ejemplo.
Consultar los valores en tabla
| Grupo | η | Probabilidad |
|---|---|---|
| Puntual | log(1/4) ≈ −1,386 | 20 % |
| Tardío | log(1/2) ≈ −0,693 | 33,3 % |
En un modelo con varios predictores la lectura del coeficiente se hace manteniendo constantes los demás. Un coeficiente positivo aumenta el logit y por tanto la probabilidad, pero el incremento en puntos depende del punto de partida. Multiplicar por dos las odds de una probabilidad del 50 % lleva al 66,7 %; multiplicar por dos las de un riesgo del 1 % lleva aproximadamente al 1,98 %. No hay un único incremento porcentual universal.
Cómo aprende a predecir sin conocer las respuestas futuras
Lectura de contraste ↗En el entrenamiento sí conocemos el resultado de cada envío. Si el modelo le asignó p=0,2 y acabó tarde, su aportación a la verosimilitud es 0,2; si llegó a tiempo, es 0,8. El exponente y escoge el primer término solo cuando se observó un retraso. Su complemento escoge el segundo en el caso contrario. Así se puede escribir la misma regla para todas las filas.
Para un retraso real, asignar p=0,2 aporta log(0,2)≈−1,609. Asignar p=0,8 habría aportado aproximadamente −0,223. Como buscamos el máximo, anticipar mejor el resultado da una aportación mayor. Un algoritmo numérico cambia los coeficientes hasta que ya no mejora apreciablemente el total. El ajuste habitual no minimiza los residuos cuadrados del apartado anterior.
Hay un caso que engaña al mirar solo los aciertos. Si todos los envíos con x=1 llegan tarde y ninguno con x=0 lo hace, los datos están completamente separados. El método puede empujar el tamaño de los coeficientes cada vez más lejos y acercar las probabilidades a cero y uno, sin encontrar un máximo finito convencional. Un aviso de falta de convergencia merece investigación, aunque todos los puntos aparezcan clasificados correctamente.
La decisión tiene una unidad distinta
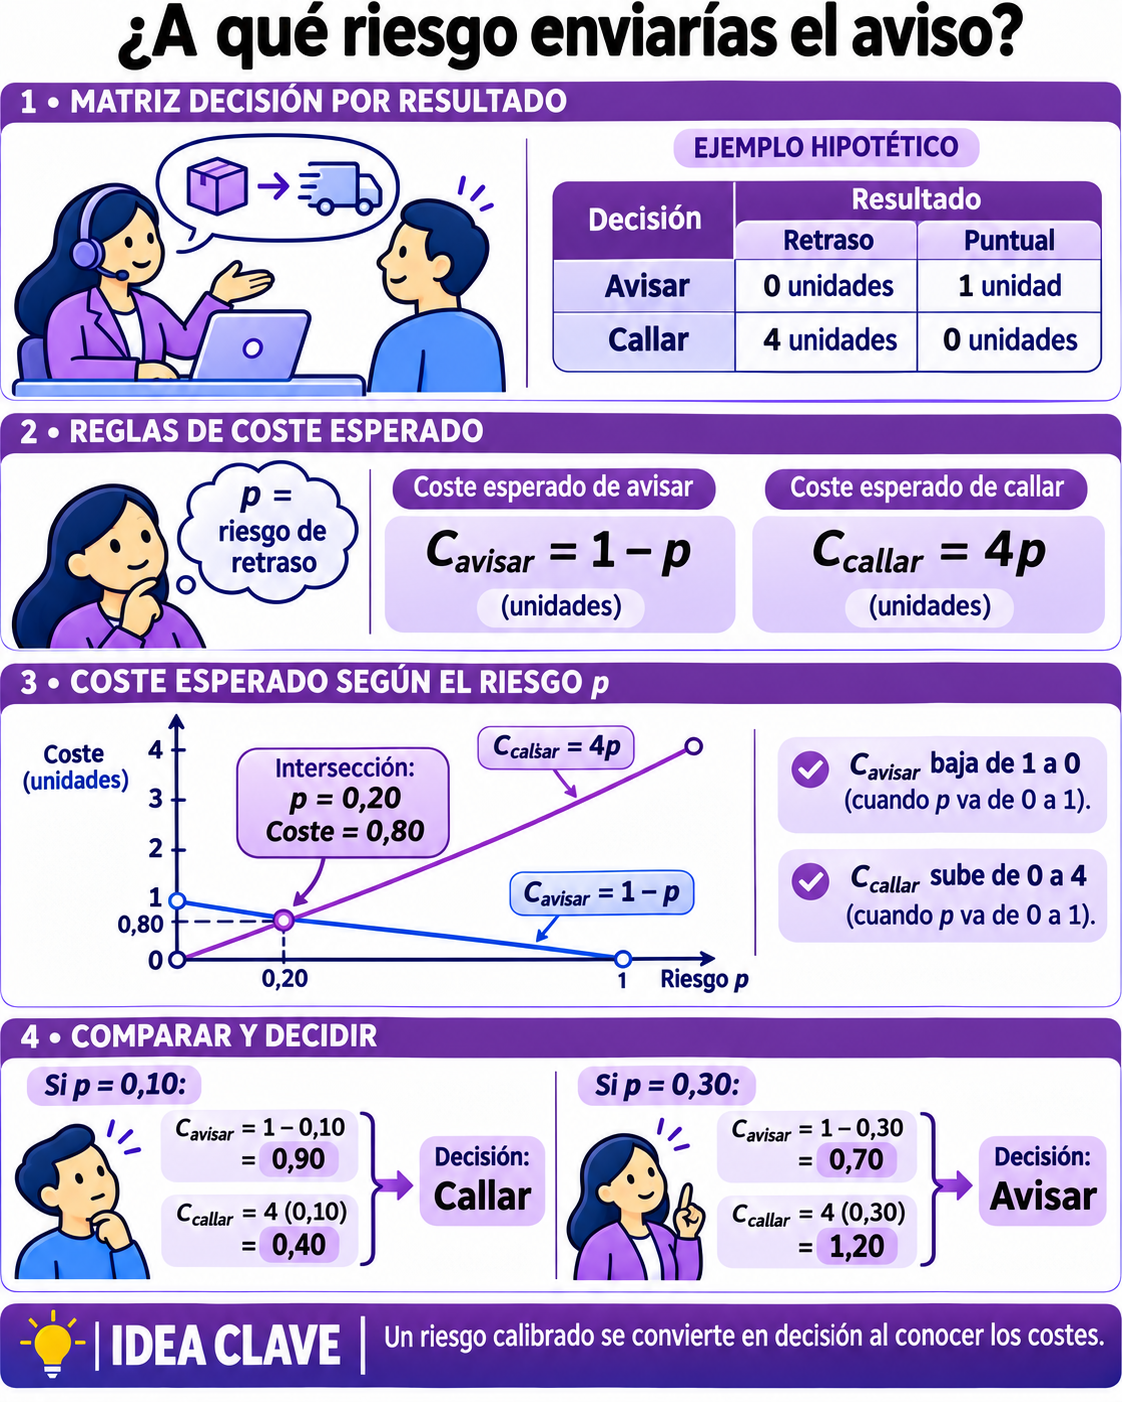
Lectura de contraste ↗Para decidir si avisar, supongamos que una falsa alarma cuesta una unidad por la llamada innecesaria y que un retraso sin aviso cuesta cuatro por la gestión posterior. Suponemos por ahora coste cero cuando se acierta. Para un envío cuyo riesgo calibrado sea p, avisar cuesta en promedio 1×(1−p), porque solo se paga si no hay retraso. No avisar cuesta 4×p. No hace falta entrenar otro modelo solo para comparar esos costes.
¿Qué acción queda debajo de la otra?
Mantén fijos los costes de la matriz y compara tres riesgos posibles. La mejor acción es la de menor altura, porque el eje vertical mide pérdida esperada. En el cruce ambas acciones cuestan lo mismo.
Consultar los valores en tabla
| Riesgo | Avisar | Callar |
|---|---|---|
| 10 % | 0,90 | 0,40 |
| 20 % | 0,80 | 0,80 |
| 30 % | 0,70 | 1,20 |
Un envío con p=1/3 sí merece el aviso bajo esos supuestos: avisar cuesta en esperanza dos tercios de una unidad, mientras callar cuesta cuatro tercios. El umbral de 0,5 habría dejado sin aviso el mismo envío. Con p=0,2 las dos opciones empatan. Si las llamadas se pueden hacer solo a cuarenta clientes, o si el aviso reduce el retraso real en vez de paliar sus consecuencias, habría que reformular la decisión.
La empresa reentrena con el mismo número de retrasos y entregas puntuales, aunque los retrasos sean raros en producción. El clasificador sigue ordenando bien los envíos. ¿Es seguro usar el umbral del 20 %?
Contrasta tu respuesta
No basta que ordene bien. Hay que comprobar la calibración con envíos representativos: entre paquetes a los que asigna aproximadamente 20 %, ¿qué fracción se retrasa realmente? Un muestreo artificial de clases puede alterar los riesgos absolutos. El orden puede servir para priorizar llamadas y, a la vez, las cifras resultar inadecuadas para comparar costes. Antes de activar avisos mediría calibración, costes y capacidad sobre un periodo posterior.
Una tabla de riesgo para el centro de atención
Toma cien paquetes cuyo riesgo previsto sea aproximadamente un tercio. Si las probabilidades están bien calibradas para esta población, esperaríamos alrededor de treinta y tres retrasos y sesenta y siete entregas puntuales. Avisar a todos generaría unos sesenta y siete avisos innecesarios. No avisar a ninguno dejaría unos treinta y tres retrasos sin comunicar. Con los costes del artículo, las dos alternativas cuestan aproximadamente sesenta y siete frente a ciento treinta y tres unidades por cien paquetes. Son las mismas cifras del cálculo individual multiplicadas por cien, no un nuevo modelo.
Ahora cambia el contrato: llamar cuesta una unidad siempre, incluso si el retraso era real. Si no se llama, un retraso sigue costando cuatro; si se llama, se evita ese coste. La comparación pasa a ser uno frente a cuatro veces la probabilidad. El umbral sería un cuarto. No puedes seguir usando un quinto solo porque haya un «uno» y un «cuatro» en ambos contratos: la matriz de pérdidas cambió. Antes de ajustar un umbral conviene escribir las cuatro casillas de acción y resultado con sus unidades.
¿Qué pasaría si el equipo priorizara simplemente los veinte envíos de mayor riesgo? La ordenación daría un primer criterio incluso cuando las probabilidades estuvieran descalibradas. Sin embargo, «vale la pena llamar al vigésimo» exige información que una ordenación no proporciona: necesita costes y riesgo absoluto. Es posible que todos los riesgos sean tan bajos que ninguna llamada compense, o que haya más de veinte que sí compensarían si se ampliara la capacidad. La restricción de personal modifica la política de decisión.
En el registro de entrenamiento anota también qué se conocía al salir el camión. Si incluyes el tiempo de llegada real para predecir si llegará tarde, fabricarás una regresión con grandes resultados y ninguna utilidad operativa. Si incluyes el último aviso al cliente cuando este solo se envía después del retraso, el problema es el mismo aunque el nombre de la columna parezca inocente. Una probabilidad condicional solo sirve para decidir si puedes observar sus condiciones en el momento de actuar.
Un cierre útil al responsable sería: «La salida tardía duplica las odds en nuestro ejemplo ajustado; el riesgo pasa del veinte por ciento a un tercio. Con la matriz de pérdidas acordada sí avisaríamos al segundo grupo. Revisaremos esta calibración cuando cambien rutas, operadores o contratos». Cada frase tiene un respaldo distinto: un coeficiente, su transformación y una decisión empresarial.
Comprueba los números
Pega el bloque en un archivo llamado prueba.py y ejecuta python3 prueba.py en su carpeta. También puedes pegarlo entero en una celda de un cuaderno Python.
from math import exp, log
for x in (0,1):
    p = 1/(1+exp(-(log(1/4)+x*log(2))))
    print(x, round(p,3), round(1-p,3), round(4*p,3))
print("umbral con coste de omisión 9:", 1/(1+9))
Salida comprobada
0 0.2 0.8 0.8
1 0.333 0.667 1.333
umbral con coste de omisión 9: 0.1
Haz una variación
Cambia el multiplicador de odds de 2 a 4. En la fila x=1 el riesgo pasa a 0,5. El programa sigue imprimiendo costes esperados, no casos observados: avisar cuesta 0,5 y callar 2.
Salida de la variación comprobada
0 0.2 0.8 0.8
1 0.5 0.5 2.0
umbral con coste de omisión 9: 0.1
Para contrastar
Penn State · STAT 504, Lesson 6. Estructura del logit, odds y verosimilitud binaria; los costes del ejemplo son supuestos didácticos, no resultados empíricos.
Google · Machine Learning Crash Course, Sigmoid function. Contrasta la transformación de log-odds a probabilidad y la forma de la sigmoide con la expresión del manual. No prescribe el umbral de producción.
Expediente de lectura: obras consultadas y alcance.
Glosario
- Logit
- Logaritmo natural de p dividido por uno menos p.
- Calibración
- Correspondencia entre probabilidades anunciadas y frecuencias observadas en casos comparables.
- Separación
- Situación en que una frontera separa completamente los resultados binarios.
Procedencia y revisión editorial
Idioma: español. Edición local: 4 de noviembre de 2026. Programa: material de estudio de la unidad 1 y diapositivas de clase de UTAMED. Las cifras de la bitácora son ejemplos didácticos construidos. La procedencia académica y el alcance de cada lectura se detallan en el expediente de fuentes.
Redacción y revisión: Codex, modelo fijado por el cliente; Python para reproducir los cálculos. Infografías y retrato interpretativo: ImageGen. La portada del libro es la imagen editorial de la web de los autores. Para las locuciones se utiliza VoiceStudio local con el perfil autorizado de Iván. Los reproductores se habilitan cuando existe un audio verificado.