Matemáticas aplicadas a la IA · Bitácora de estudio
¿Por qué una predicción segura puede salir tan cara?
La confianza importa incluso cuando dos modelos aciertan el mismo número de veces. Una pieza revela por qué.
Contenido de la bitácora
Ejercicio propuesto: inspección de piezas. No son datos de una fábrica. En una línea de inspección hay dos modelos que anuncian si una pieza va a fallar. En una pieza que finalmente falla, uno había asignado al fallo un 80 % y el otro un 5 %. Ambos daban números, pero solo uno había dejado espacio razonable al resultado que ocurrió. ¿Cómo medir esa diferencia sin tirar las probabilidades y quedarnos solo con acierto o error?
Una etiqueta conocida, un coste
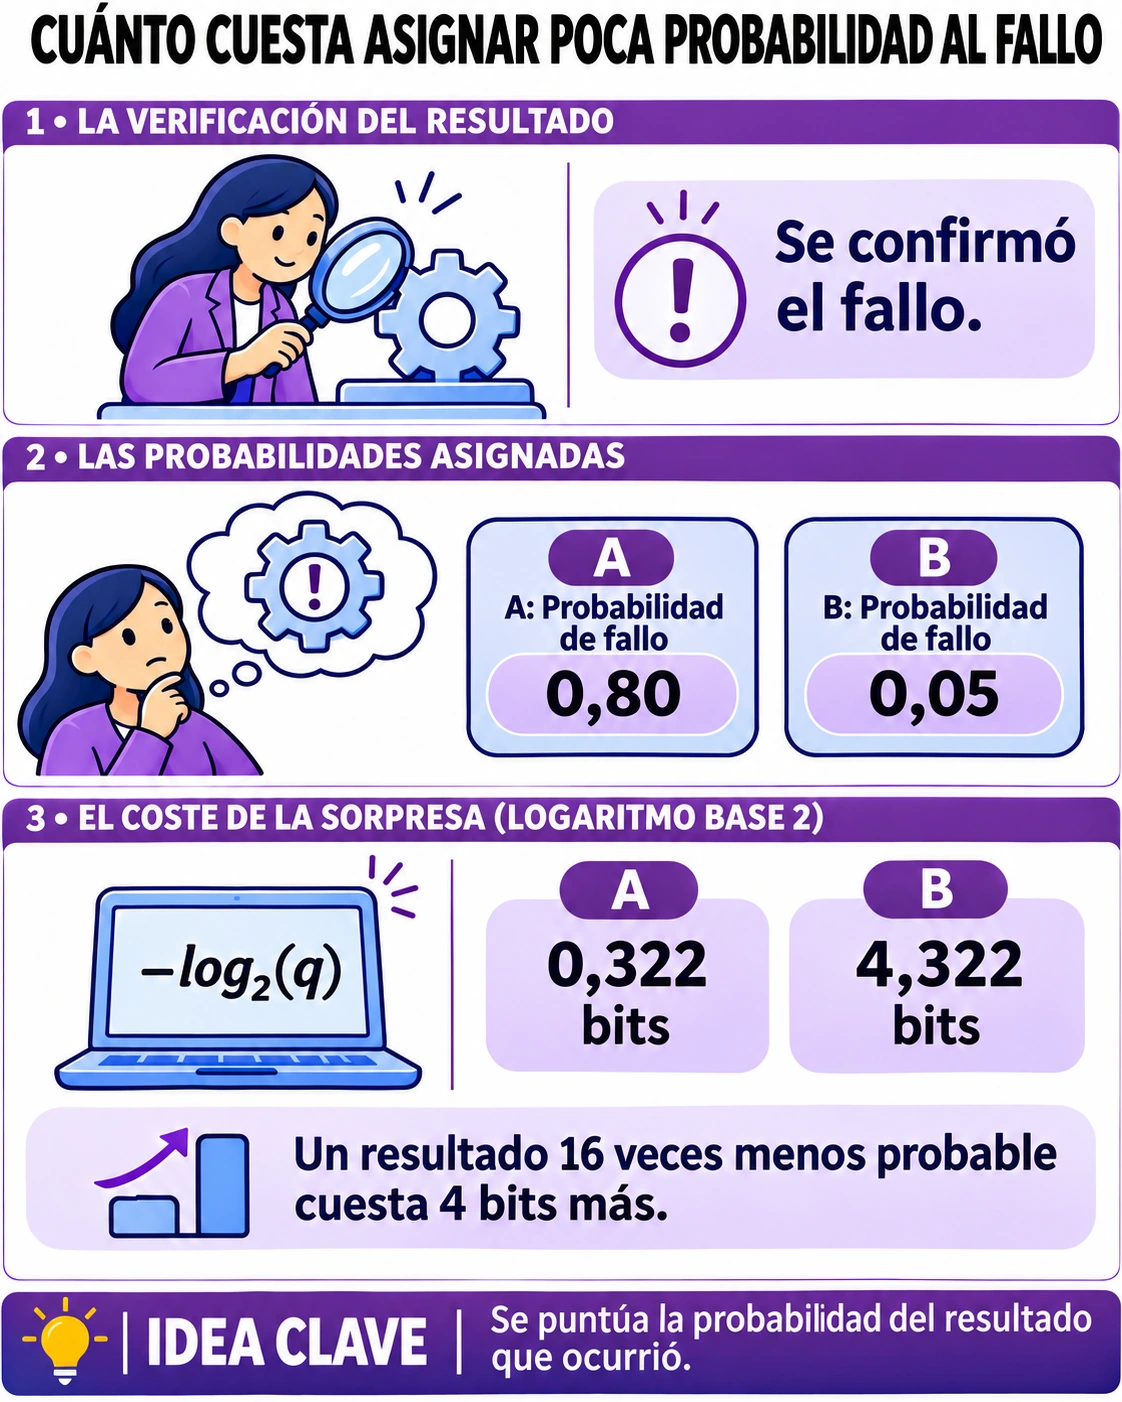
Llamaremos q a la probabilidad que publica el modelo. Al conocer el resultado y, le cobramos menos si había asignado más probabilidad a y. Para que los costes de observaciones independientes se puedan sumar, aplicamos el logaritmo a la probabilidad y cambiamos el signo. [3]
L(y,q) = −log₂ q(y)
En la pieza que falla, el primer modelo paga −log₂ 0,8 ≈ 0,322 bits. El segundo paga −log₂ 0,05 ≈ 4,322 bits. ¿De dónde salen los cuatro bits de diferencia? El primero asignó dieciséis veces más probabilidad al mismo resultado, y dieciséis es dos elevado a cuatro. Repetir este cálculo en una muestra de prueba y tomar la media permite comparar probabilidades, incluso cuando dos modelos aciertan la misma etiqueta al elegir el máximo.
Hay un matiz práctico. Si la inspección es binaria y la pieza no falla, el coste utiliza uno menos la probabilidad de fallo, porque ese es el resultado que sí se observó. Cambiar el significado del uno entre entrenamiento y evaluación puede invertir el resultado sin generar ningún error de software.
Las tres cantidades que conviene no mezclar
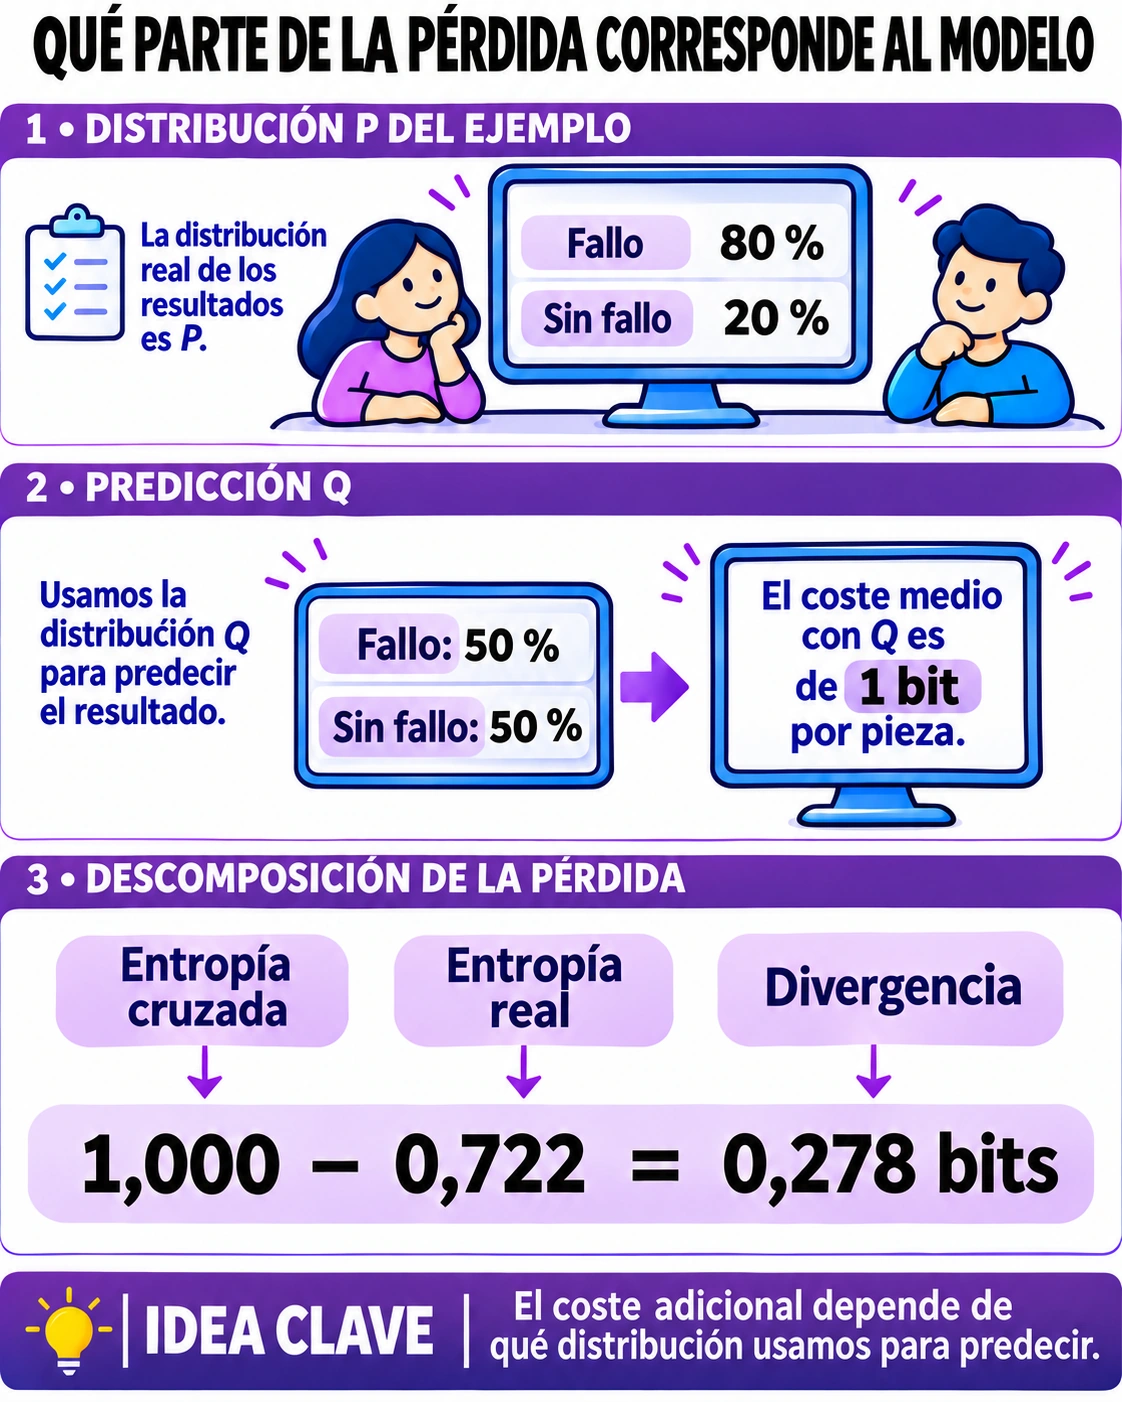
Supón ahora una línea hipotética en la que el fallo ocurre con probabilidad 0,8, y un predictor que insiste en repartir sus probabilidades por igual. Denominamos P al reparto real supuesto en el ejercicio y Q al reparto del predictor. Queremos saber cuánto nos cuesta, de media, describir resultados de P con las probabilidades de Q. [12]
H(P,Q) = −Σᵧ P(y) log₂ Q(y)
Cada resultado cuesta un bit con Q, por tanto la entropía cruzada es exactamente un bit por pieza. Si usáramos el reparto correcto, el coste medio sería la entropía H(P), aproximadamente 0,722 bits. El exceso que se debe a usar Q recibe el nombre de divergencia KL de P respecto de Q. Réstale al coste medio del modelo el coste medio ideal.
D(P‖Q) = H(P,Q) − H(P) = Σᵧ P(y) log₂[P(y)/Q(y)]
El cociente aparece al restar dos logaritmos. No hay que interpretar cada término como un coste necesariamente positivo: un resultado raro puede costar menos con Q que con P. Lo que nunca es negativo es el exceso medio. Aquí vale aproximadamente 0,278 bits por pieza.
Invierte el sentido y el promedio también cambia. D(Q‖P) vale 0,5 log₂(0,5/0,8) + 0,5 log₂(0,5/0,2) ≈ 0,322 bits. El primer argumento determina qué distribución pone los pesos. Por eso la divergencia no es una distancia geométrica. Tampoco hay un umbral universal por debajo del cual un modelo sea bueno: 0,01 bits de exceso por evento y cien millones de eventos representan un coste acumulado distinto que diez observaciones.
Comprueba el mecanismo
Deja fija en 80 % la tasa real. Lleva el pronóstico desde 50 hasta 80. Luego asigna un cero: mira qué sucede con los fallos que el modelo negaba.
¿Qué sale de una red de clasificación?
Una red multiclase suele emitir puntuaciones reales, llamadas logits. No tienen por qué ser positivas ni sumar uno. Para interpretarlas como una distribución se aplica softmax: a cada puntuación se le toma la exponencial y se divide entre la suma de las exponenciales de todas las clases. [2]
qₖ = exp(sₖ) / Σⱼ exp(sⱼ)
Si las puntuaciones son ln 3 y cero, sus exponenciales son tres y uno. La red anuncia probabilidades de tres cuartos y un cuarto. Si la etiqueta verdadera es la segunda, su vector de etiqueta tiene un uno en la segunda posición y cero en las demás. En la suma de entropía cruzada solo sobrevive −log₂(1/4) = 2 bits. Una biblioteca que use logaritmos naturales mostrará ln 4 ≈ 1,386 nats. Son dos unidades para la misma pérdida.
Al usar una función que pide logits, dale las puntuaciones originales. Volver a aplicar softmax a probabilidades ya normalizadas cambia la predicción que se evalúa. El nombre de la función no basta: comprueba el contrato de entrada y la base del logaritmo en su documentación.
El caso que no admite vuelta atrás
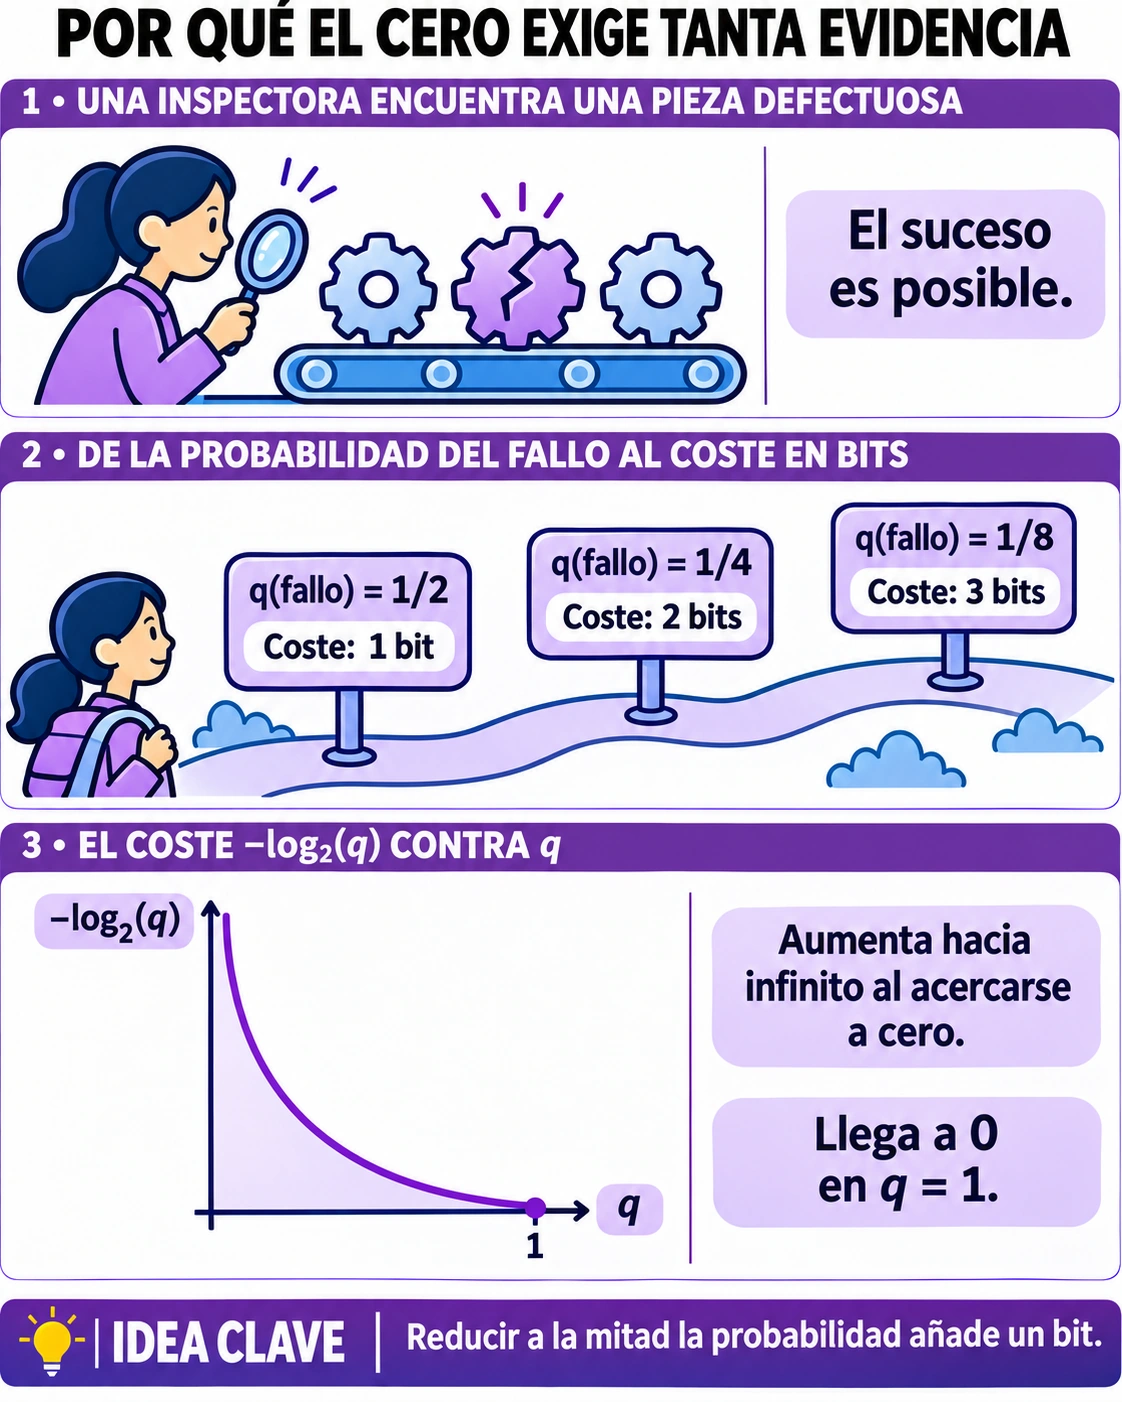
Si Q atribuye cero a un resultado posible bajo P, el cociente del logaritmo diverge. No pasa nada parecido por asignar a ese mismo resultado una probabilidad pequeña pero positiva: un error seguro y un error muy confiado tienen consecuencias matemáticas distintas. Las implementaciones pueden recortar probabilidades para evitar infinitos de máquina. Si comparas herramientas, comprueba el recorte y anota la diferencia con la definición teórica. [16]
Prueba de transferencia
Dos predictores aciertan nueve de diez casos. Al resultado observado en cada acierto asignan 0,6 y 0,9, respectivamente; en el fallo asignan 0,4 y 0,0001. ¿Gana necesariamente el más confiado?
Comprobar razonamiento
No. En bits, el primero paga [9(−log₂ 0,6) − log₂ 0,4]/10 ≈ 0,795. El segundo paga [9(−log₂ 0,9) − log₂ 0,0001]/10 ≈ 1,466. Un error muy seguro compensa sobradamente sus nueve pequeñas mejoras. El porcentaje de aciertos no captura este efecto.
Qué justificar al comparar modelos
Usa las mismas observaciones y la misma unidad. El rendimiento medio observado estima una esperanza; en datos reales P no viene impresa en una etiqueta. Reducir la entropía cruzada esperada equivale a reducir la divergencia cuando P se mantiene fija, porque su entropía es una constante. Esta afirmación no garantiza que un modelo entrenado en una línea mantenga la calibración al instalarlo en otra con una tasa de fallos diferente. [13]
Del resultado individual a la media de prueba
Imagina que el panel del equipo muestra dos cantidades: pérdida media de 0,2 y exactitud de 92 %. Antes de decidir cuál mejora, revisa si se calcularon sobre las mismas piezas, en el mismo período y con el mismo peso. Si las piezas defectuosas son raras, repetirlas para equilibrar el conjunto cambia lo que significa la media. Puede ser útil evaluar por separado fallos y piezas correctas; para recuperar una media operacional, vuelve a ponderar por las frecuencias de la línea, no por la frecuencia elegida para el ensayo.
En una pérdida binaria se suele ver la expresión menos y por el logaritmo de q menos uno menos y por el logaritmo de uno menos q. No hay dos predicciones observadas. El valor de y, cero o uno, selecciona el único término que pertenece al resultado. Si el resultado es uno, el segundo término lleva factor cero; si es cero, desaparece el primero. Esta forma permite poner todas las filas en una sola fórmula. Al promediar filas con etiqueta conocida obtienes la entropía cruzada empírica. No necesitas conocer la verdadera distribución de cada pieza para evaluarla.
¿Y si todos los modelos asignan probabilidad alta a los mismos casos pero ninguno acierta la frecuencia real? El orden de riesgo y la calidad de las probabilidades son propiedades diferentes. Un inspector que solo pueda revisar las diez piezas más sospechosas podría obtener el mismo orden con ambos modelos. Un presupuesto que multiplica probabilidad de fallo por coste de reparación sí cambia. De ahí la importancia de comprobar qué hará el negocio con las probabilidades y de observar las frecuencias reales por grupos de pronóstico.
Para practicar sin calculadora, compara q del resultado verdadero igual a un medio, un cuarto y un octavo. El coste es uno, dos y tres bits. Cada vez que reduces la probabilidad a la mitad pagas exactamente un bit adicional. Una predicción de 0,25 para la clase correcta no cuesta el doble que una de 0,50 por una relación lineal con la probabilidad; justo aquí cuesta dos bits en vez de uno porque los valores forman potencias de dos. Al cambiar la base a logaritmo natural el salto pasa a ln 2.
¿Qué información pierde el marcador de aciertos?
Antes de programar escribe dos columnas: etiqueta que salió y probabilidad que el modelo había publicado para esa etiqueta. Si salió cero, esta última será uno menos la probabilidad de la clase uno. Guarda las probabilidades originales; aplicar un umbral antes de medir la pérdida convertiría una predicción prudente en una etiqueta terminante. En el ejemplo siguiente el modelo A y el B eligen exactamente la misma etiqueta para cada pieza. Ambos aciertan dos de tres. Uno resulta preferible para responder una pregunta sobre probabilidades; aún no conocemos el coste de detener la línea para decidir qué umbral operativo conviene.
Guárdalo como practica.py y ejecuta python3 practica.py en una terminal. También puedes pegar el bloque en una celda de Jupyter y pulsar Mayús + Intro.
from math import log2

etiquetas = [1, 1, 0]
modelos = {"A": [0.6, 0.6, 0.6], "B": [0.9, 0.9, 0.99]}
for nombre, prob in modelos.items():
    aciertos = sum(int(p >= 0.5) == y for p, y in zip(prob, etiquetas))
    asignadas = [p if y else 1-p for p, y in zip(prob, etiquetas)]
    coste = sum(-log2(p) for p in asignadas) / len(etiquetas)
    print(nombre, aciertos, round(coste, 3))
Salida comprobada
A 2 0.932
B 2 2.316
La última pieza es decisiva: el modelo B dijo 0,99 para la clase uno y ocurrió la clase cero. Recibir el resultado al que solo dejó un 1 % pesa más que recibir un fallo al que el A reservaba un 40 %. Sustituye en B ese 0,99 por 0,60. Su etiqueta predicha seguirá siendo uno y seguirá fallando, pero ahora su coste medio cae: dos modelos con el mismo historial de aciertos pueden merecer comparaciones muy distintas.
Glosario de esta entrada
- Logit
- Puntuación real sin normalizar de una clase.
- Etiqueta one-hot
- Vector con un uno en la clase observada y ceros en las demás.
- Calibración
- Correspondencia entre probabilidades pronosticadas y frecuencias de resultados en grupos comparables.
Origen y edición
Manual §6.1 y §6.3, pp. 30–33 · Diapositivas 77–79. Material de Matemáticas aplicadas a la IA y al Deep Learning (UTAMED). Los datos de los casos son hipotéticos y las preguntas sirven para practicar; no proceden de un examen.
Edición en español · 4 de noviembre de 2026. Texto asistido por Codex; infografías de ImageGen.
Lecturas contrastadas
Estas veinte obras y documentos se consultaron para preparar la explicación. La nota indica qué pregunta ayuda a resolver cada uno. El expediente distingue los pasajes de las obras y los resúmenes accesibles; no presupone lectura íntegra de todos los originales.
Descargar expediente de investigación
- Proper Scoring Rules for Estimation and Forecast Evaluation | Annual ReviewsSitúa el logaritmo entre las reglas que premian declarar probabilidades honestas.
- CrossEntropyLoss — PyTorch 2.14 documentationAclara por qué el argumento de entrada son logits, no probabilidades obtenidas con softmax.
- Strictly Proper Scoring Rules, Prediction, and Estimation (Revised) | University of Washington Department of StatisticsUna regla estrictamente propia alcanza su óptimo esperado en la distribución verdadera.
- log_loss — scikit-learn 1.9.1 documentationPermite contrastar base natural, promedio y recorte numérico del logaritmo.
- ASCMO - Proper scoring rules for multivariate probabilistic forecasts based on aggregation and transformationDistingue evaluar una distribución y evaluar solo una etiqueta.
- evaluating_distributions – MLmetrics: Machine Learning for EconometriciansConecta coste cruzado, entropía y divergencia en una evaluación predictiva.
- Multilayer perceptrons for digit recognition with Core APIs | TensorFlow CoreLleva la pérdida multiclase desde las puntuaciones de una red hasta la etiqueta correcta.
- The ensemble‐adjusted Ignorance Score for forecasts issued as normal distributions - Siegert - 2019 - Quarterly Journal of the Royal Meteorological Society - Wiley Online LibraryComprueba que evaluar probabilidades aproximadas con un conjunto finito puede introducir sesgo.
- Probabilistic forecasts, calibration and sharpness - Gneiting - 2007 - Journal of the Royal Statistical Society: Series B (Statistical Methodology) - Wiley Online LibrarySepara calibración y concentración de las distribuciones predictivas.
- Evaluating Probabilistic Forecasts Using Information TheoryInterpreta la puntuación de ignorancia en unidades de información.
- Towards Accurate and Calibrated Classification: Regularizing Cross-Entropy From A Generative PerspectiveExpone un caso en que buen ajuste de clasificación y confianza calibrada se separan.
- Notes on Kullback-Leibler Divergence and LikelihoodJustifica el vínculo matemático entre divergencia y verosimilitud.
- On Calibration of Modern Neural NetworksDemuestra empíricamente que una red precisa puede ser demasiado confiada.
- tf.keras.losses.categorical_crossentropy | TensorFlow v2.16.1Permite comprobar qué significa from_logits en una salida categórica.
- Non-Parametric Calibration for ClassificationCompara probabilidades publicadas con frecuencias observadas por intervalos.
- scipy.special.rel_entr — SciPy v1.18.0 ManualDocumenta el convenio en cero y la singularidad cuando el modelo niega un evento posible.
- Calibrating multi-class modelsUtiliza predicciones multiclase para comprobar que el vector de probabilidades completo importa.
- On Computationally Efficient Multi-Class CalibrationMuestra por qué la calidad de la calibración depende del uso posterior de las probabilidades.
- Expectation consistency for calibration of neural networksDistingue procedimientos de calibración que pueden mejorar la confianza después de entrenar.
- Theoretical Analysis of Calibration in Binary ClassificationExamina la diferencia entre comportamiento observado en una muestra y calibración poblacional.