ADICTOS A LA IA · MATEMÁTICAS · UNIDAD 1
¿Cuántas alarmas corresponden a defectos reales?
10 minutos de lectura · Manual, pp. 10–13 · Diapositivas 36–39
La cámara de la línea cuatro detecta nueve de cada diez piezas defectuosas. Al final del turno, control de calidad abre la caja de piezas apartadas y encuentra que la mayoría están bien. ¿Hay que recalibrar la cámara? Antes de tocar un ajuste, conviene leer despacio esas dos frases. La primera empieza contando defectos. La segunda empieza contando alarmas.
Vamos a reconstruir el turno con 10 000 piezas hipotéticas. Podremos calcular qué parte de la caja necesita reparación. Después cambiaremos una sola cosa: cuántos defectos llegan a la línea.
El escenario: 10 000 piezas y dos denominadores
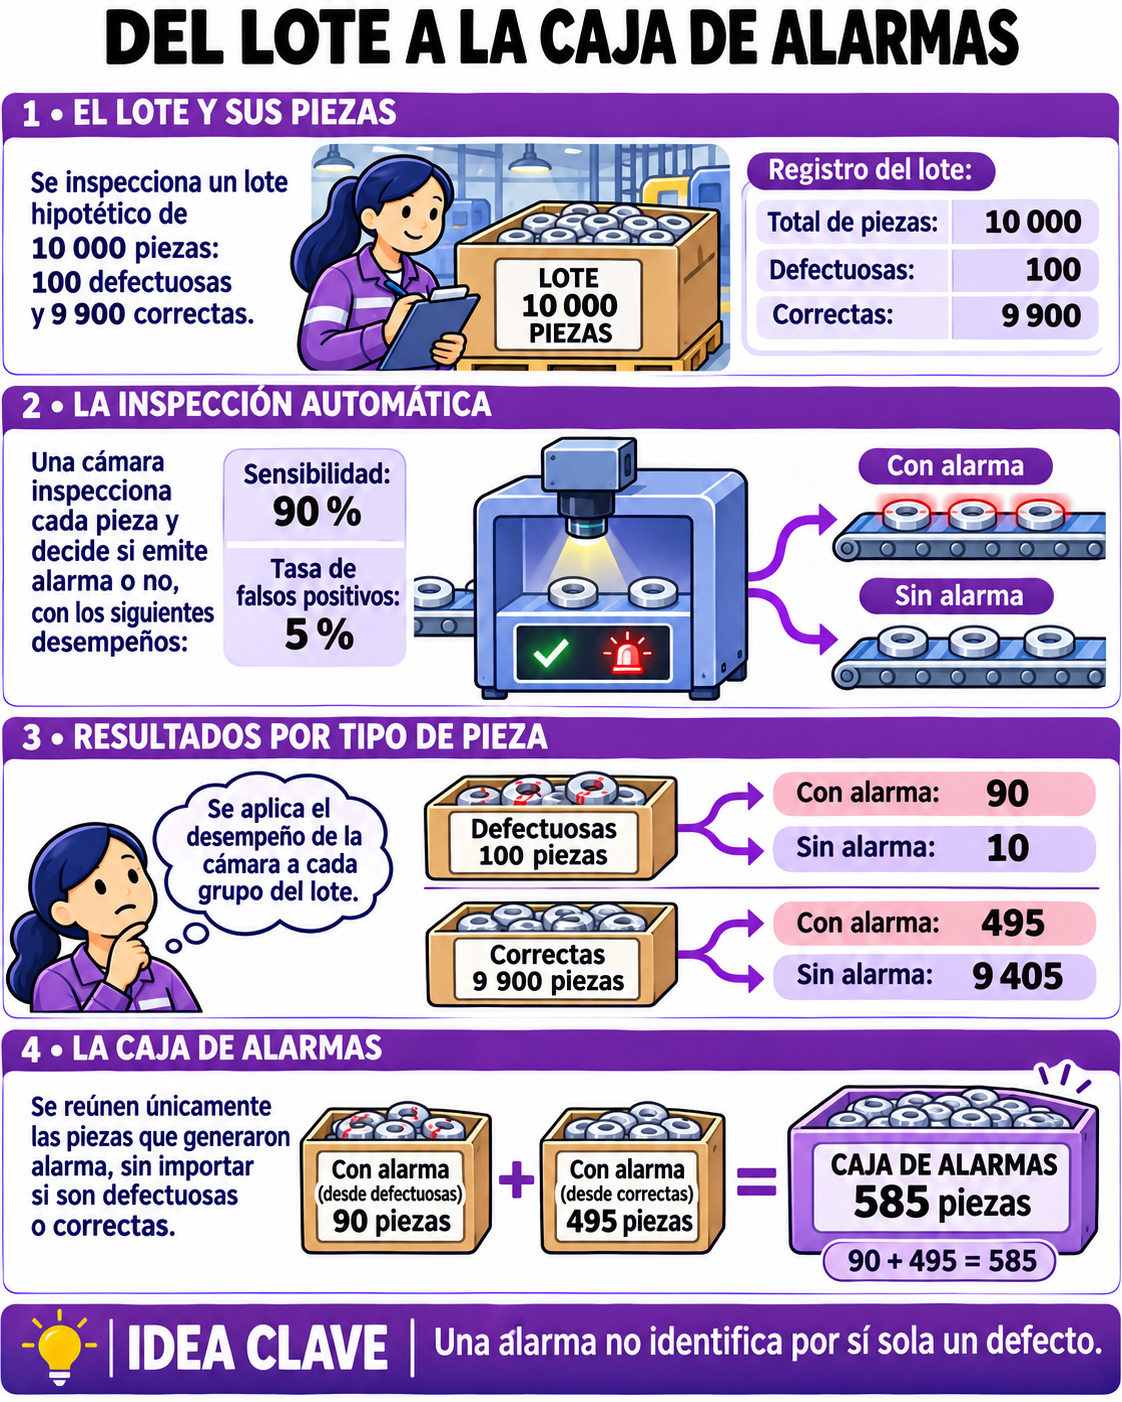
Imagina que nuestra fábrica produce 10 000 piezas. Para este ejercicio suponemos que hay 100 piezas defectuosas. La prevalencia de defectos (probabilidad a priori) es del 1 %. Esto significa que, antes de ver cualquier alarma, asumimos que solo 100 piezas son defectuosas y 9 900 son correctas.
Nuestro sistema de IA se evalúa con dos tasas, cada una con su propio denominador:
- Sensibilidad, o tasa de verdaderos positivos: 90 %. Si una pieza es defectuosa, la IA lo detecta el 90 % de las veces.
- Tasa de Falsos Positivos: 5 %. Si una pieza es correcta, la IA se equivoca y suena la alarma el 5 % de las veces (especificidad del 95 %).
A primera vista, parece un sistema excelente: detecta casi todos los fallos y solo comete errores en un pequeño porcentaje. Sin embargo, aquí es donde entra en juego la tasa base (base rate). La mayoría de las piezas son buenas. Por lo tanto, aunque el error sea pequeño (5 %), se aplica a una población enorme (9 900 piezas), generando un volumen absoluto de falsas alarmas que puede abrumar a los verdaderos defectos.
¿Por qué hay que dividir entre todas las alarmas?
Vamos a calcular la probabilidad real de que una pieza sea defectuosa dado que la alarma ha sonado. Denotemos:
- \( D \): Evento "Pieza Defectuosa".
- \( A \): Evento "Alarma suena".
Queremos calcular \( P(D|A) \), la probabilidad posterior. Según el Teorema de Bayes:
\[ P(D|A) = \frac{P(A|D) \cdot P(D)}{P(A)} \]Leamos cada término con su denominador:
- \( P(D) \): Probabilidad a priori. Es la prevalencia. \[ P(D) = 0.01 \]
- \( P(A|D) \): Verosimilitud (Sensibilidad). Probabilidad de alarma si hay defecto. \[ P(A|D) = 0.90 \]
- \( P(A) \): Evidencia marginal. Es la probabilidad total de que suene la alarma, ya sea por un defecto real o por un error del sistema. Se calcula usando la regla de la probabilidad total: \[ P(A) = P(A|D)P(D) + P(A|\neg D)P(\neg D) \]
Aquí, \( P(\neg D) \) es la probabilidad de que la pieza sea correcta (\( 1 - 0.01 = 0.99 \)) y \( P(A|\neg D) \) es la tasa de falsos positivos (0.05).
Sustituyamos los valores en el numerador (proporción de todas las piezas que son verdaderos positivos):
\[ \text{Numerador} = 0.90 \times 0.01 = 0.009 \]Ahora, el denominador (total de alarmas). Calculamos la parte de falsos positivos:
\[ P(A|\neg D)P(\neg D) = 0.05 \times 0.99 = 0.0495 \]Sumamos para obtener \( P(A) \):
\[ P(A) = 0.009 + 0.0495 = 0.0585 \]Finalmente, dividimos el numerador entre el denominador:
\[ P(D|A) = \frac{0.009}{0.0585} \approx 0.1538 \]En el ejemplo, 90 de las 585 piezas apartadas tienen defecto: 15,38 %. Las otras 495 justifican el 84,62 % restante. El 90 % de sensibilidad describía una pregunta distinta: de las 100 piezas defectuosas que entraron, ¿cuántas detectó la cámara?
El impacto de cambiar la prevalencia: Comparación con el 10 %
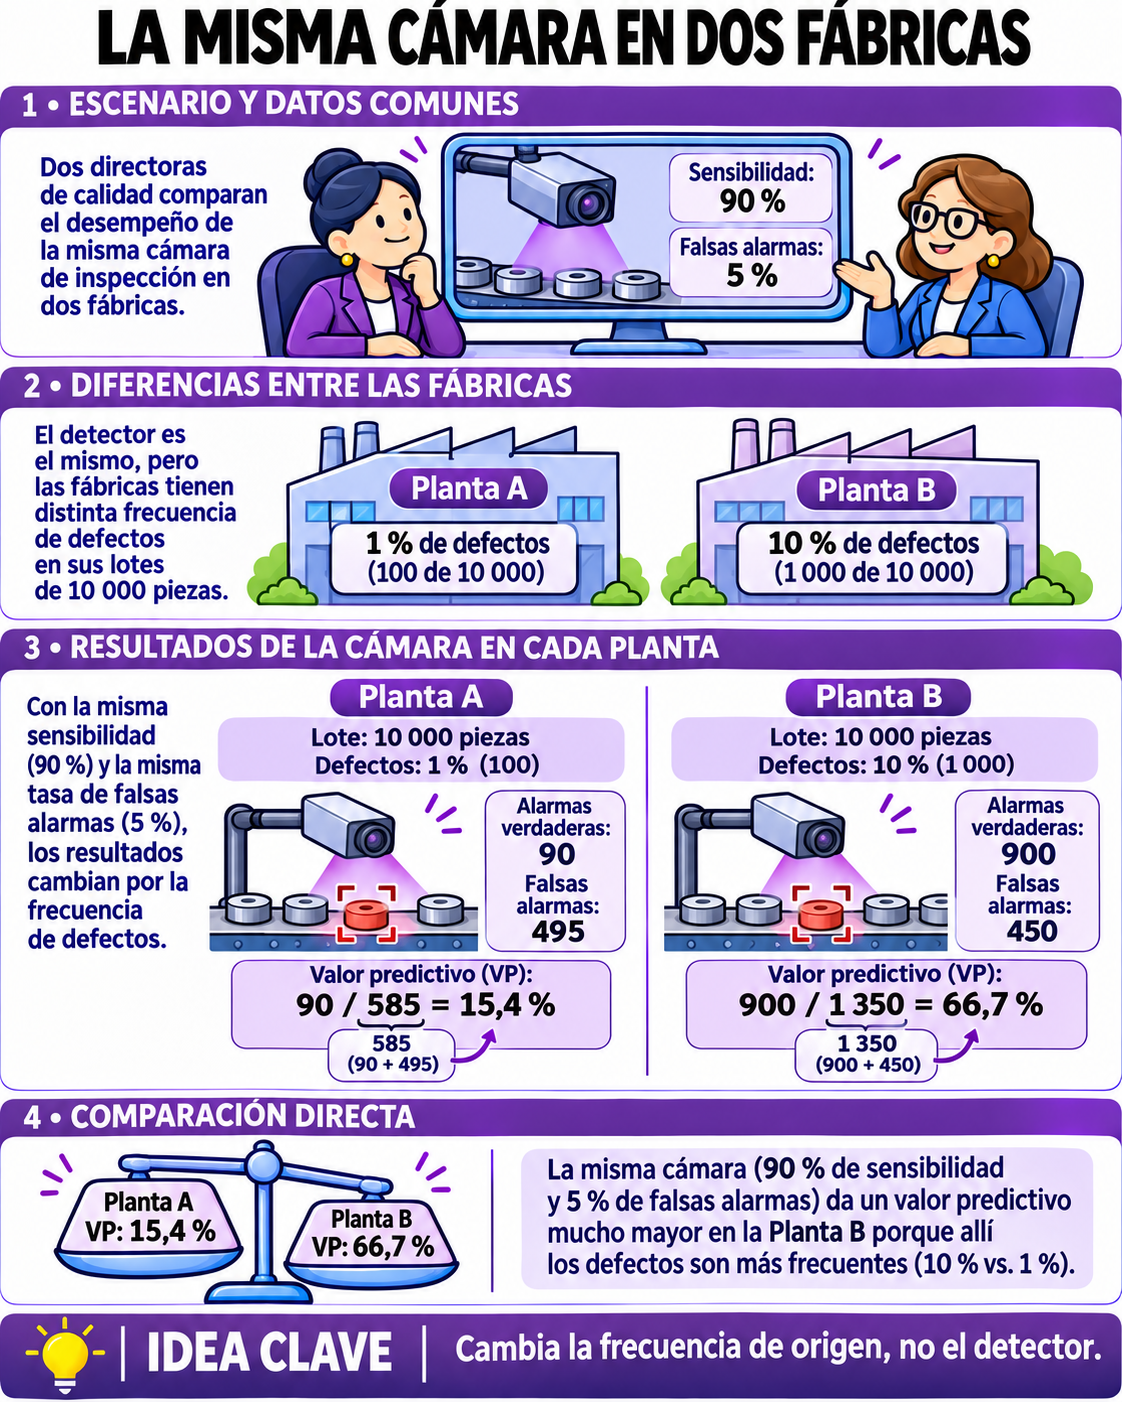
¿Qué pasaría si tuviéramos un lote sospechoso donde estimamos que la tasa de defectos es del 10 %? La sensibilidad y los falsos positivos del sensor no cambian, pero cambia nuestra creencia inicial.
| Parámetro | Caso 1: Prevalencia 1 % | Caso 2: Prevalencia 10 % |
|---|---|---|
| Piezas Totales (hipotético) | 10 000 | 10 000 |
| Defectuosas Reales | 100 | 1 000 |
| Correctas Reales | 9 900 | 9 000 |
| Verdaderos Positivos (90 %) | 90 | 900 |
| Falsos Positivos (5 %) | 495 | 450 |
| Total Alarmas | 585 | 1 350 |
| Probabilidad Real (PPV) | 15.38 % | 66.67 % |
Observa el cambio drástico. Al aumentar la prevalencia al 10 %, la probabilidad de que una alarma sea real salta al 66.67 %. Esto ilustra la importancia crítica del contexto: una alarma del mismo sensor tiene mayor valor predictivo positivo en entornos de alto riesgo que en cribados masivos de baja incidencia.
Otra cuenta útil: las odds antes y después de la alarma
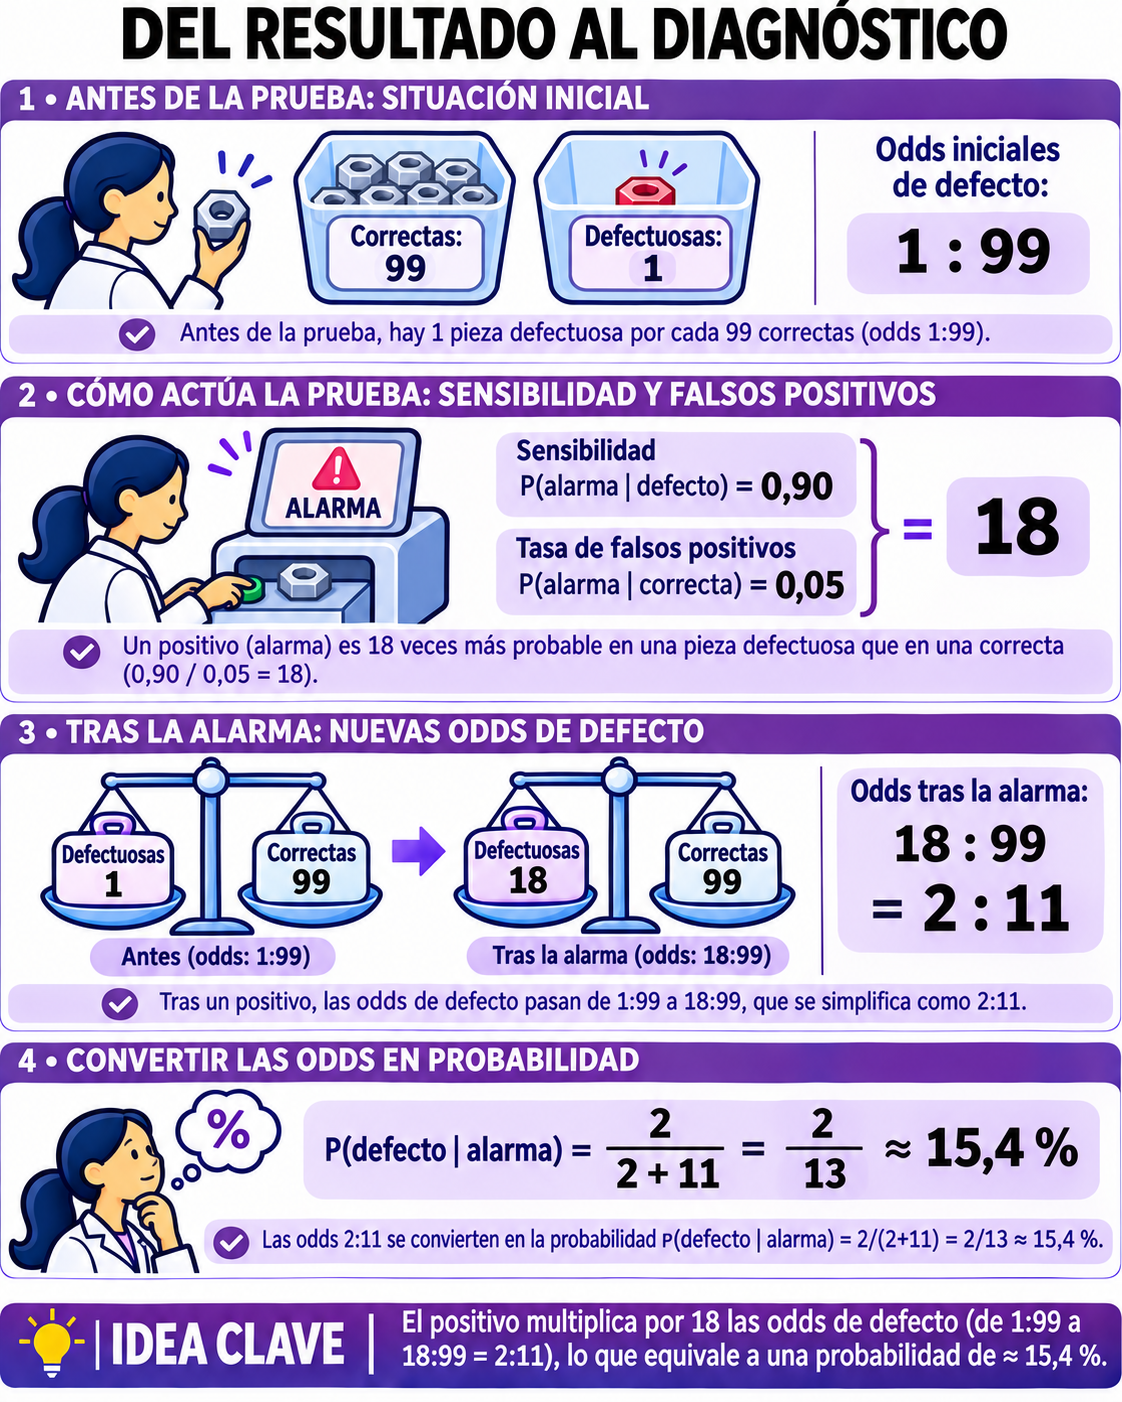
Las odds comparan la probabilidad de un defecto con la de una pieza correcta. Si hay un defecto por cada 99 piezas correctas, las odds son uno a 99; la probabilidad, en cambio, es uno entre 100. La razón de verosimilitudes positiva dice por cuánto multiplicamos las odds cuando observamos una alarma. Necesitamos la tasa inicial para convertir el resultado en probabilidad.
\[ LR+ = \frac{\text{Sensibilidad}}{1 - \text{Especificidad}} = \frac{P(A|D)}{P(A|\neg D)} \]Sustituyendo nuestros valores:
\[ LR+ = \frac{0.90}{0.05} = 18 \]Una \( LR+ \) de 18 indica que la evidencia (la alarma) es 18 veces más probable si la pieza es defectuosa que si es correcta. Aunque suene alto, debemos combinarlo con la probabilidad pretest. Si convertimos la prevalencia del 1 % a odds (cociente de probabilidades), obtenemos \( \frac{0.01}{0.99} \approx 0.0101 \). Multiplicamos por la razón de verosimilitud:
\[ \text{Odds Posttest} = 0.0101 \times 18 \approx 0.1818 \]Convertimos de nuevo a probabilidad: \( \frac{0.1818}{1 + 0.1818} \approx 0.1538 \). Llegamos al mismo resultado, pero esta metodología es escalable y permite comparar diferentes sensores si se mantienen constantes la sensibilidad y la especificidad en ambas poblaciones.
¿Qué aspecto tiene una alarma poco informativa?
Podemos contrastar nuestro 18 con un resultado observado fuera de la fábrica. En un estudio retrospectivo de 1 237 personas en un hospital colombiano, la razón de verosimilitud positiva de la escala original de Ginebra fue 1,3. Supongamos unas odds iniciales de uno a nueve: multiplicarlas por 1,3 apenas mueve la probabilidad del 10 % al 12,6 %. Con el multiplicador 18 del ejemplo industrial pasaríamos al 66,7 %. La operación es la misma; la fuerza de la evidencia es distinta. El estudio describe una población concreta y no valida las cifras hipotéticas de nuestra cámara.
Independencia y errores frecuentes
Un error común entre los ingenieros júnior es asumir que las alarmas son eventos independientes. Si el sensor tiene un sesgo sistemático (por ejemplo, se calienta y empieza a fallar más), las observaciones no son independientes. En ese caso, aplicar Bayes directamente sin ajustar por la correlación entre errores puede llevar a sobreestimar la confianza del modelo. Bayes sigue siendo válido; lo que falla es multiplicar como independientes las razones de dos observaciones dependientes.
Otro error frecuente es ignorar la tasa base. Un contraejemplo clásico es el diagnóstico médico: si una enfermedad afecta a 1 de cada millón y una prueba tiene un 1 % de falsos positivos, casi todas las alarmas positivas serán falsas, incluso con una sensibilidad perfecta. La intuición humana tiende a enfocarse en la capacidad del instrumento para discriminar y descuidar la rareza del evento.
La cuenta del manual: 92 positivos verdaderos y 990 falsos
El manual (pp. 12–13) plantea un ejemplo docente de tuberculosis: prevalencia del 1 %, sensibilidad del 92 % y especificidad del 90 %. En una población hipotética de 10 000 personas tendríamos 100 casos y 9 900 personas sin la enfermedad. Habría 92 positivos entre los primeros y 990 entre las segundas, porque la tasa de falsos positivos es el 10 %.
\[P(\mathrm{enfermedad}\mid+) = \frac{92}{92+990}\approx 0{,}0850.\]El resultado del manual es aproximadamente 8,5 %. No es el 15,38 % de nuestra cámara: las dos pruebas tienen tasas diferentes. Para trasladar la cuenta a otro grupo habría que conocer la prevalencia y el rendimiento de la prueba en ese grupo. Una prevalencia de la población general no describe necesariamente a personas seleccionadas por presentar síntomas.
Ejercicio resuelto: Filtro de Spam
Para consolidar, apliquemos esto a un filtro de correo. Supongamos:
- Prevalencia de spam: 20 % (\( P(S) = 0.2 \)).
- Sensibilidad (detecta spam): 95 %.
- Falsos positivos (marca correo bueno como spam): 2 %.
Calculamos \( LR+ \):
\[ LR+ = \frac{0.95}{0.02} = 47.5 \]Convertimos la prevalencia a odds:
\[ \text{Odds Pretest} = \frac{0.2}{0.8} = 0.25 \]Odds Posttest:
\[ 0.25 \times 47.5 = 11.875 \]Probabilidad posterior:
\[ P(S|A) = \frac{11.875}{1 + 11.875} \approx 0.922 \]En este caso, si el filtro marca un correo como spam, hay un 92.2 % de probabilidad de que lo sea. La mayor prevalencia y la menor tasa de error hacen que el sistema sea mucho más confiable que en el caso de las piezas defectuosas.
Pregunta de transferencia
Imagina que implementamos un segundo sensor idéntico al primero, cuyos errores son independientes de los del primero tanto entre las piezas defectuosas como entre las correctas. Si ambos sensores suenan la alarma para la misma pieza, ¿cuál es la nueva probabilidad de que sea defectuosa? (Mantén la prevalencia del 1 %).
Solución oculta
Bajo esa independencia condicional, podemos usar el resultado anterior como nuevo a priori. La primera alarma dejó una probabilidad posterior aproximada del 15,38 %. La usamos como punto de partida de la segunda actualización.
Odds Pretest (después de la 1ª alarma) = \( \frac{0.1538}{1-0.1538} \approx 0.1818 \).
Aplicamos la misma LR+ (18) del segundo sensor:
Odds Posttest (2ª alarma) = \( 0.1818 \times 18 \approx 3.27 \).
Probabilidad final = \( \frac{3.27}{1 + 3.27} \approx 0.766 \).
La probabilidad sube al 76,6 %. Con dos positivos la probabilidad de defecto aumenta, pero solo bajo la independencia condicional que acabamos de suponer.
Glosario técnico
- Prevalencia (Probabilidad a priori): Frecuencia de un evento en la población antes de aplicar cualquier prueba o filtro.
- Sensibilidad: Capacidad del sistema para detectar correctamente los casos positivos (verdaderos positivos).
- Especificidad: Capacidad del sistema para identificar correctamente los casos negativos (verdaderos negativos).
- Falso Positivo: Error tipo I; el sistema indica un evento cuando no ocurre.
- Razón de Verosimilitud Positiva (\( LR+ \)): Cociente entre la sensibilidad y la tasa de falsos positivos. Indica por cuánto se multiplican las odds de la hipótesis al observar una prueba positiva.
- Odds (Cociente): Relación entre la probabilidad de que ocurra un evento y la de que no ocurra (\( p / (1-p) \)).
- Teorema de Bayes: Fórmula matemática que describe la probabilidad de un evento, basada en conocimientos previos relacionados.
Volvamos a la caja de la línea cuatro: si encontramos unas 90 piezas defectuosas entre 585 apartadas, la cámara puede estar funcionando exactamente como se diseñó. Para decidir si se recalibra necesitamos otra comparación: el coste de revisar las 495 piezas correctas frente al coste de dejar pasar alguno de los diez defectos que no detectó.
Abrir expediente: fuentes, pasajes consultados y límites